Florent Delgrange, ricercatore postdoc presso l'Artificial Intelligence Lab della Vrije Universiteit Brussel (VUB), ha vinto il Best Blue Sky Paper Award ad AAMAS 2026 con un articolo dedicato ai foundation world model per agenti che apprendono, verificano e si adattano in modo affidabile oltre gli ambienti statici. Il lavoro delinea un'agenda di ricerca, non un sistema già completo. La domanda centrale è come un agente autonomo possa continuare ad apprendere mentre il suo mondo cambia, senza perdere silenziosamente le garanzie che rendevano affidabile il suo comportamento.
Due metodi, una lacuna
Delgrange parte dai limiti di due approcci consolidati. Il reinforcement learning permette a un agente di apprendere per tentativi ed errori e può scalare ad ambienti in cui nessuno potrebbe scrivere a mano tutte le regole. Di solito, però, all'agente si chiede di massimizzare una ricompensa. Una ricompensa specificata male può essere sfruttata in modo improprio, e una ricompensa elevata non dimostra che un requisito di sicurezza o di coordinamento sia stato rispettato.
La sintesi reattiva procede in senso opposto. Dati un modello dell'ambiente e una descrizione logica del comportamento desiderato, è in grado di costruire una policy corretta per progettazione. Il suo punto debole è che in genere richiede un modello esplicito e fisso, che un agente in un mondo aperto e in evoluzione non possiede.
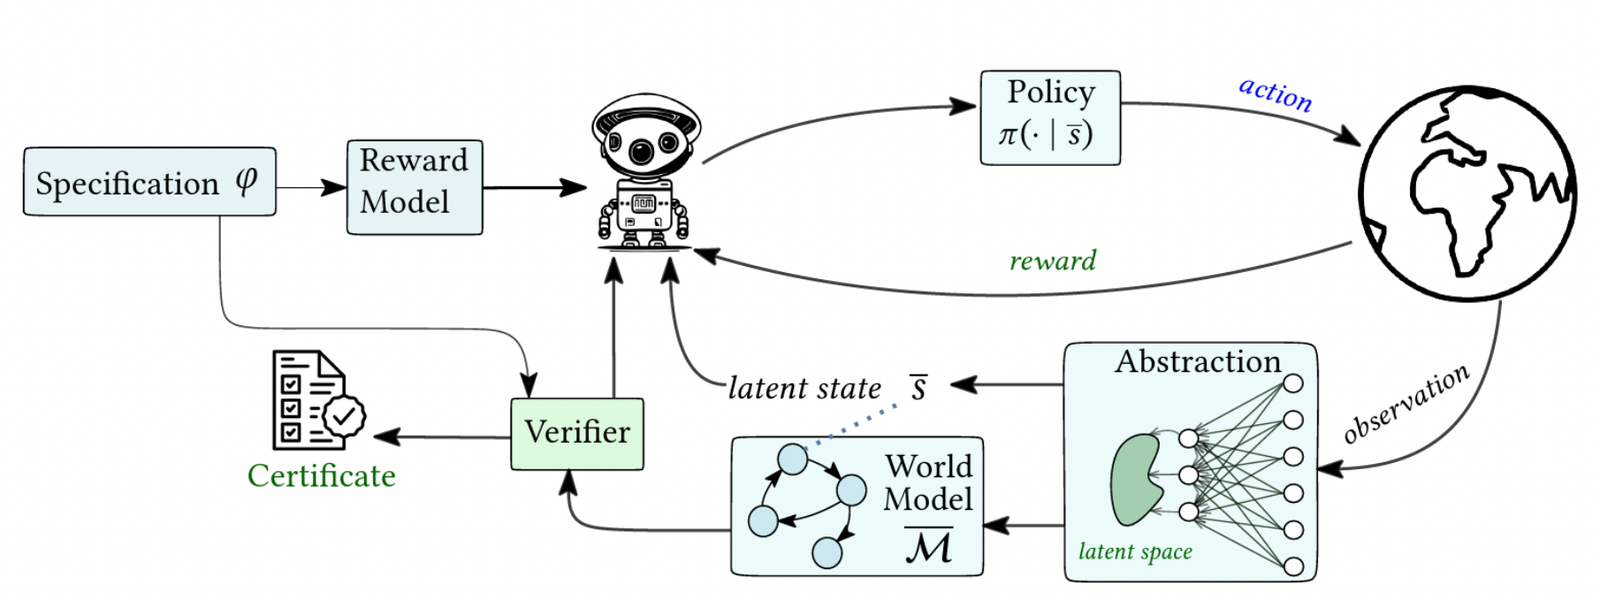
L'articolo propone di unire i due approcci in un unico ciclo. Un world model verrebbe appreso dall'esperienza, ma strutturato in modo che un verificatore possa ragionarci sopra. Mentre l'agente apprende una policy, aggiornerebbe il modello, misurerebbe l'affidabilità della propria astrazione e controllerebbe se la policy soddisfa ancora la specifica. Il feedback del verificatore potrebbe respingere un aggiornamento non sicuro, richiedere dati da una regione incerta oppure innescare una revisione del modello.
Che cosa dovrebbe saper fare il modello
Delgrange usa il termine «foundation» nel senso di riutilizzo, non di dimensione. Non descrive un predittore video più grande addestrato su più traiettorie, ma un modello persistente e strutturato che l'agente porta con sé attraverso compiti, policy e popolazioni di agenti in mutamento. Lo paragona a una mappa che registra quali aree sono state rilevate, quali conclusioni dipendono da esse e quando un cambiamento ha reso inaffidabile un vecchio percorso.
Indica tre proprietà. Il modello dovrebbe essere calibrato, così che ogni astrazione appresa sia accompagnata da una misura del proprio errore o della propria copertura e l'agente sappia dove valgono le conclusioni formali. Dovrebbe essere componibile, in modo che dinamiche locali verificate, comportamenti e certificati possano essere riutilizzati quando si assembla un nuovo compito. E dovrebbe essere interrogabile semanticamente, così che un requisito formale o un'istruzione di alto livello aiuti a ricavare un modello di ricompensa, un'astrazione specifica per il compito o un prior di policy con poca esperienza aggiuntiva.
Ciò si distingue dalla maggior parte dei metodi model-based attuali, che apprendono per uno specifico compito, ambiente, policy o distribuzione di addestramento e vengono valutati soprattutto sull'accuratezza predittiva. Delgrange sostiene che l'accuratezza media non equivale all'idoneità a sostenere una garanzia. Nel suo esempio del magazzino, un modello potrebbe prevedere correttamente quasi ogni transizione ma non cogliere una rara interazione con un carrello elevatore. Quell'unica transizione decide se un'affermazione di evitamento delle collisioni sia valida. Un modello compatto che ignora colori e texture, al contrario, potrebbe conservare tutto ciò che serve per ragionare su percorsi e collisioni.
Un robot da magazzino come banco di prova
L'esempio concreto è un robot per le consegne, con il compito formulato come «consegnare prima o poi il pacco evitando sempre le collisioni». Il sistema tradurrebbe questo requisito in un modello di ricompensa, in modo che apprendimento e verifica partano dalla stessa descrizione. Il verificatore si chiederebbe poi se la policy soddisfa il requisito nel modello appreso e se l'astrazione è abbastanza accurata lungo i percorsi rilevanti perché la conclusione sia affidabile.
Se un carrello elevatore iniziasse a usare una scorciatoia raramente visitata, il modello dovrebbe ridurre la propria confidenza in quella regione. Il verificatore ritirerebbe il certificato interessato, respingerebbe un aggiornamento di policy rischioso, orienterebbe l'esplorazione verso la scorciatoia e ripristinerebbe la garanzia solo dopo la ricalibrazione del modello.
L'articolo considera anche un ciclo in fase di test con un modello linguistico. Il modello linguistico proporrebbe piccoli programmi formali che descrivono nuove dinamiche. Un model checker li metterebbe alla prova e restituirebbe un controesempio o un'incoerenza strutturale in caso di errore. Il modello linguistico rivedrebbe l'ipotesi, il robot raccoglierebbe esperienza mirata e il ciclo si ripeterebbe. Nelle parole di Delgrange, il modello linguistico propone e il verificatore formale controlla.
Sistemi multi-agente
Il problema è più difficile con più agenti, perché ogni agente che apprende fa parte dell'ambiente di tutti gli altri. Le dinamiche effettive cambiano quando gli agenti aggiornano le policy, entrano o escono dal sistema, condividono informazioni o assumono nuovi obiettivi. Delgrange suggerisce che un foundation world model potrebbe collegare ogni policy locale alle ipotesi alla base del suo certificato. Se un robot cambia percorso, il sistema potrebbe individuare le garanzie coinvolte, raccogliere dati dove serve e rivedere solo quei componenti, invece di riverificare l'intera flotta. I guasti verrebbero accompagnati da un controesempio che mostra quale interazione ha invalidato un certificato.
Indica la scalabilità come principale ostacolo. Lo spazio degli stati congiunto cresce rapidamente con il numero di agenti, e le garanzie locali non si compongono automaticamente in una garanzia globale.
Analisi: che cosa dimostra e che cosa no
Il premio riconosce una direzione di ricerca, e l'articolo non riporta un sistema funzionante. Delgrange afferma che i tasselli esistono già: traduzioni formali delle ricompense, astrazioni verificabili, metodi di miglioramento sicuro delle policy e generazione di programmi. Manca un agente end-to-end efficiente che li mantenga tutti calibrati mentre apprende. È un'affermazione sull'integrazione, ed è proprio sull'integrazione che programmi di questo tipo spesso si arenano.
L'idea è rilevante perché cambia il criterio con cui si giudica un world model. I modelli odierni sono ottimizzati per prevedere bene in media. L'esempio del magazzino di Delgrange mostra perché questo può non bastare per le garanzie di sicurezza: un piccolo errore in una singola transizione può invalidare una garanzia che la media nasconde. Rendere le informazioni di affidabilità parte del modello, legate a una specifica policy e a un requisito, è uno standard più esigente della sola accuratezza predittiva. Inoltre tratta la certificazione come un lavoro continuo, in linea con i contesti operativi in cui le condizioni cambiano nel tempo.
Rispetto alle due tradizioni che unisce, la proposta mantiene la scalabilità del reinforcement learning e le garanzie esplicite di correttezza della sintesi reattiva, ma dipende da un elemento che nessuna delle due fornisce: una misura affidabile di quando un'astrazione appresa è abbastanza buona da sostenere una conclusione formale. Se tale calibrazione possa essere resa abbastanza precisa da risultare utile, senza essere così conservativa da portare il verificatore a respingere la maggior parte degli aggiornamenti, non trova risposta nelle evidenze della descrizione dell'articolo.
Diverse affermazioni restano non dimostrate. Nessun risultato mostra che la verifica possa essere abbastanza veloce da influenzare l'apprendimento online. Nessun risultato mostra che i programmi proposti da un modello linguistico e controllati da un model checker convergano in pratica verso dinamiche corrette. E per i contesti multi-agente, lo stesso Delgrange dice che i metodi per preservare la correttezza (soundness) nella composizione devono ancora essere trovati. Finché questi punti non saranno dimostrati, i foundation world model vanno letti come un insieme di requisiti ben argomentato per agenti adattivi sicuri, e la prossima prova da attendere è un prototipo che chiuda il ciclo anche solo su un compito di scala ridotta, come quello di un magazzino.