Florent Delgrange, investigador posdoctoral del Laboratorio de Inteligencia Artificial de la Vrije Universiteit Brussel (VUB), ganó el premio al Mejor Artículo Blue Sky en AAMAS 2026 por un trabajo sobre modelos de mundo fundacionales para agentes que aprenden, verifican y se adaptan de forma fiable más allá de los entornos estáticos. El artículo plantea una agenda de investigación, no un sistema terminado. Su pregunta central es cómo puede un agente autónomo seguir aprendiendo a medida que su mundo cambia, sin perder de forma silenciosa las garantías que hacían confiable su comportamiento.
Dos métodos, una brecha
Delgrange parte de los límites de dos enfoques consolidados. El aprendizaje por refuerzo permite que un agente aprenda por ensayo y error y puede escalar a entornos en los que nadie podría escribir todas las reglas. Sin embargo, normalmente se le pide al agente que maximice una recompensa. Una recompensa mal especificada puede explotarse, y una recompensa alta no demuestra que se haya cumplido un requisito de seguridad o de coordinación.
La síntesis reactiva funciona en sentido contrario. Dado un modelo del entorno y una descripción lógica del comportamiento deseado, puede construir una política correcta por diseño. Su debilidad es que normalmente necesita un modelo explícito y fijo, algo de lo que un agente en un mundo abierto y cambiante no dispone.
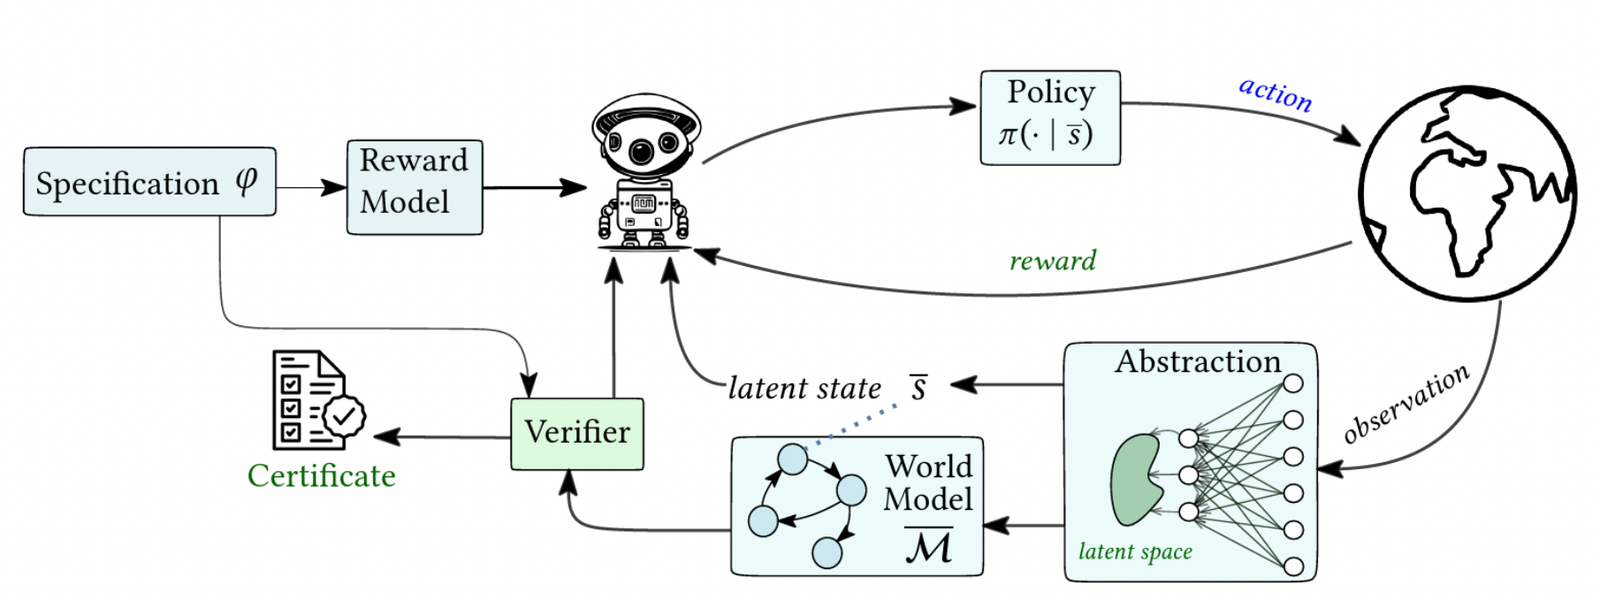
El artículo propone unir ambos enfoques en un único ciclo. Se aprendería un modelo de mundo a partir de la experiencia, pero estructurado de manera que un verificador pueda razonar sobre él. A medida que el agente aprende una política, actualizaría el modelo, mediría la fiabilidad de su abstracción y comprobaría si la política sigue cumpliendo su especificación. La retroalimentación del verificador podría rechazar una actualización insegura, solicitar datos de una región incierta o desencadenar una revisión del modelo.
Lo que tendría que hacer el modelo
Delgrange usa el término «fundacional» para referirse a la reutilización, no al tamaño. No describe un predictor de vídeo más grande entrenado con más trayectorias, sino un modelo persistente y estructurado que el agente lleva consigo a través de tareas, políticas y poblaciones cambiantes de agentes. Lo compara con un mapa que registra qué zonas se han explorado, qué conclusiones dependen de ellas y cuándo un cambio ha vuelto poco fiable una ruta antigua.
Señala tres propiedades. El modelo debe estar calibrado, de modo que cada abstracción aprendida incluya una medida de su error o cobertura y el agente sepa dónde son válidas las conclusiones formales. Debe ser composicional, para que las dinámicas locales verificadas, los comportamientos y los certificados puedan reutilizarse al armar una nueva tarea. Y debe poder consultarse semánticamente, de modo que un requisito formal o una instrucción de alto nivel ayude a derivar un modelo de recompensa, una abstracción específica de la tarea o un prior de política con poca experiencia adicional.
Esto se distingue de la mayoría de los métodos actuales basados en modelos, que aprenden para una tarea, entorno, política o distribución de entrenamiento concretos y se evalúan sobre todo por su precisión predictiva. Delgrange sostiene que la precisión media no equivale a la idoneidad para sustentar una garantía. En su ejemplo del almacén, un modelo podría predecir casi todas las transiciones correctamente pero pasar por alto una interacción poco frecuente con una carretilla elevadora. Esa única transición decide si una afirmación de evitación de colisiones es válida. En cambio, un modelo compacto que ignore colores y texturas podría conservar todo lo necesario para razonar sobre rutas y colisiones.
Un robot de almacén como caso de prueba
El ejemplo desarrollado es un robot de reparto cuya tarea se formula como entregar finalmente el paquete evitando siempre las colisiones. El sistema traduciría ese requisito a un modelo de recompensa, de modo que el aprendizaje y la verificación partan de la misma descripción. El verificador se preguntaría entonces si la política cumple el requisito en el modelo aprendido y si la abstracción es lo bastante precisa a lo largo de las rutas relevantes como para confiar en esa conclusión.
Si una carretilla elevadora empieza a usar un atajo poco transitado, el modelo debería reducir su confianza en esa región. El verificador retiraría el certificado afectado, rechazaría una actualización de política arriesgada, dirigiría la exploración hacia el atajo y solo restablecería la garantía una vez recalibrado el modelo.
El artículo también contempla un ciclo en tiempo de prueba con un modelo de lenguaje. El modelo de lenguaje propondría pequeños programas formales que describan nuevas dinámicas. Un verificador de modelos (model checker) los pondría a prueba y devolvería un contraejemplo o una inconsistencia estructural cuando sean erróneos. El modelo de lenguaje revisaría su hipótesis, el robot recopilaría experiencia dirigida y el ciclo se repetiría. En palabras de Delgrange, el modelo de lenguaje propone y el verificador formal comprueba.
Sistemas multiagente
El problema es más difícil con varios agentes, porque cada agente que aprende forma parte del entorno de todos los demás. Las dinámicas efectivas cambian cuando los agentes actualizan sus políticas, entran o salen, comparten información o asumen nuevos objetivos. Delgrange sugiere que un modelo de mundo fundacional podría vincular cada política local con los supuestos que sustentan su certificado. Si un robot cambia de ruta, el sistema podría identificar las garantías afectadas, recopilar datos donde haga falta y revisar solo esos componentes, en lugar de volver a verificar toda la flota. Los fallos vendrían acompañados de un contraejemplo que mostraría qué interacción invalidó un certificado.
Señala la escalabilidad como el principal obstáculo. El espacio de estados conjunto crece rápidamente con el número de agentes, y las garantías locales no se componen automáticamente en una garantía global.
Análisis: qué establece y qué no establece este trabajo
El premio reconoce una dirección de investigación, y el artículo no presenta un sistema en funcionamiento. Delgrange afirma que las piezas ya existen: traducciones formales de recompensas, abstracciones verificables, métodos de mejora segura de políticas y generación de programas. Lo que falta es un agente integral y eficiente que las mantenga todas calibradas mientras aprende. Es una afirmación sobre integración, y la integración es donde estos programas suelen estancarse.
La idea importa porque cambia el criterio con el que se juzga un modelo de mundo. Los modelos actuales se ajustan para predecir bien en promedio. El ejemplo del almacén de Delgrange muestra por qué eso puede fallar para las afirmaciones de seguridad: un pequeño error en una transición puede invalidar una garantía que el promedio oculta. Incorporar al modelo información de fiabilidad, vinculada a una política y un requisito concretos, es un estándar más exigente que la precisión predictiva. Además, trata la certificación como un trabajo continuo, lo que encaja con despliegues en los que las condiciones cambian con el tiempo.
En comparación con las dos tradiciones que une, la propuesta conserva la escalabilidad del aprendizaje por refuerzo y las garantías explícitas de corrección de la síntesis reactiva, pero depende de una pieza que ninguna aporta: una medida fiable de cuándo una abstracción aprendida es lo bastante buena como para sustentar una conclusión formal. Si esa calibración puede ser lo bastante ajustada como para resultar útil, sin ser tan conservadora que el verificador rechace la mayoría de las actualizaciones, es algo que las pruebas de la descripción del artículo no abordan.
Varias afirmaciones siguen sin demostrarse. Ningún resultado muestra que la verificación pueda ejecutarse con la rapidez suficiente para influir en el aprendizaje en línea. Ningún resultado muestra que los programas propuestos por un modelo de lenguaje y comprobados con un verificador de modelos converjan en la práctica hacia dinámicas correctas. Y en los entornos multiagente, el propio Delgrange reconoce que aún hay que encontrar los métodos para preservar la solidez (soundness) bajo composición. Hasta que se demuestre todo esto, los modelos de mundo fundacionales se entienden mejor como un conjunto bien argumentado de requisitos para agentes adaptativos seguros, y la próxima prueba que conviene vigilar es un prototipo que cierre el ciclo, aunque sea en una tarea a escala reducida de almacén.