Florent Delgrange, chercheur postdoctoral au laboratoire d'intelligence artificielle de la Vrije Universiteit Brussel (VUB), a reçu le prix du meilleur article Blue Sky à AAMAS 2026 pour un papier consacré aux modèles du monde fondationnels, destinés à des agents capables d'apprendre, de vérifier et de s'adapter de manière fiable au-delà des environnements statiques. L'article propose un programme de recherche, pas un système abouti. Sa question centrale : comment un agent autonome peut-il continuer d'apprendre quand son monde évolue, sans perdre discrètement les garanties qui rendaient son comportement digne de confiance ?
Deux méthodes, une lacune
Delgrange part des limites de deux approches bien établies. L'apprentissage par renforcement permet à un agent d'apprendre par essais et erreurs et passe à l'échelle dans des environnements où personne ne pourrait écrire toutes les règles. Mais on demande en général à l'agent de maximiser une récompense. Une récompense mal spécifiée peut être détournée, et une récompense élevée ne prouve pas qu'une exigence de sécurité ou de coordination est respectée.
La synthèse réactive procède dans l'autre sens. À partir d'un modèle de l'environnement et d'une description logique du comportement attendu, elle peut construire une politique correcte par conception. Sa faiblesse : elle exige normalement un modèle explicite et figé, ce dont ne dispose pas un agent évoluant dans un monde ouvert et changeant.
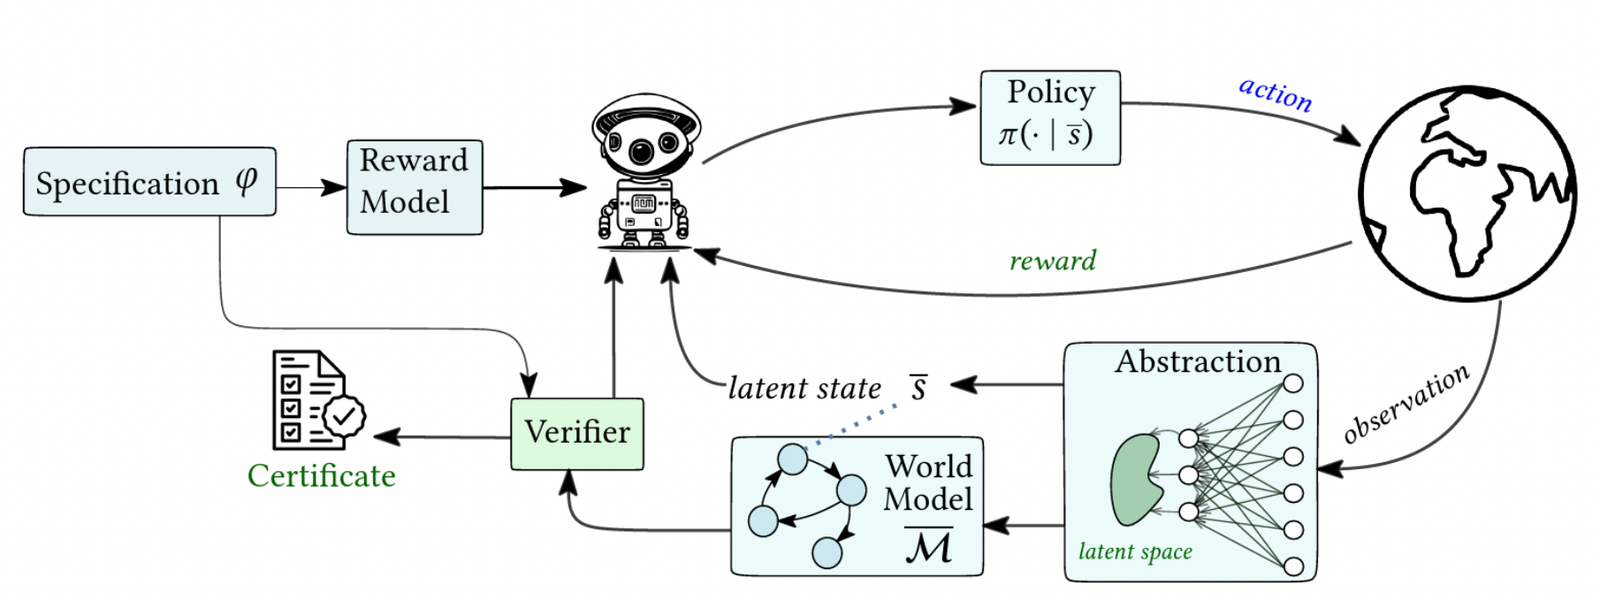
L'article propose de réunir les deux dans une même boucle. Un modèle du monde serait appris à partir de l'expérience, mais structuré de sorte qu'un vérificateur puisse raisonner dessus. Tout en apprenant une politique, l'agent mettrait à jour le modèle, mesurerait la fiabilité de son abstraction et contrôlerait si la politique respecte toujours sa spécification. Le retour du vérificateur pourrait rejeter une mise à jour dangereuse, demander des données dans une zone incertaine ou déclencher une révision du modèle.
Ce que le modèle devrait savoir faire
Delgrange emploie le mot « fondationnel » au sens de la réutilisation, pas de la taille. Il ne décrit pas un prédicteur vidéo plus gros entraîné sur davantage de trajectoires, mais un modèle persistant et structuré, qu'un agent emporte d'une tâche, d'une politique ou d'une population d'agents à l'autre. Il le compare à une carte qui consigne les zones déjà explorées, les conclusions qui en dépendent, et le moment où un changement rend un ancien itinéraire peu fiable.
Il cite trois propriétés. Le modèle doit être calibré : chaque abstraction apprise s'accompagne d'une mesure de son erreur ou de sa couverture, et l'agent sait où les conclusions formelles tiennent. Il doit être compositionnel : dynamiques locales vérifiées, comportements et certificats se réutilisent quand une nouvelle tâche est assemblée. Enfin, il doit être interrogeable sémantiquement : une exigence formelle ou une instruction de haut niveau aide à en déduire un modèle de récompense, une abstraction propre à la tâche ou un a priori de politique, avec peu d'expérience supplémentaire.
Cela diffère de la plupart des méthodes actuelles fondées sur un modèle, qui apprennent pour une tâche, un environnement, une politique ou une distribution d'entraînement donnés et sont jugées surtout sur leur précision prédictive. Pour Delgrange, la précision moyenne ne signifie pas l'aptitude à soutenir une garantie. Dans son exemple d'entrepôt, un modèle peut prédire presque toutes les transitions correctement tout en ratant une interaction rare avec un chariot élévateur. Cette seule transition décide de la validité d'une affirmation d'évitement de collision. À l'inverse, un modèle compact qui ignore couleurs et textures pourrait conserver tout ce qu'il faut pour raisonner sur les trajets et les collisions.
Un robot d'entrepôt comme cas d'étude
L'exemple développé est un robot de livraison dont la tâche est formulée ainsi : finir par livrer le colis tout en évitant toujours les collisions. Le système traduirait cette exigence en modèle de récompense, de sorte que l'apprentissage et la vérification partent de la même description. Le vérificateur se demanderait alors si la politique satisfait l'exigence dans le modèle appris, et si l'abstraction est assez précise sur les trajets concernés pour que cette conclusion soit fiable.
Si un chariot élévateur se met à emprunter un raccourci rarement visité, le modèle devrait réduire sa confiance dans cette zone. Le vérificateur retirerait le certificat concerné, rejetterait une mise à jour de politique risquée, orienterait l'exploration vers le raccourci, et ne rétablirait la garantie qu'après recalibrage du modèle.
L'article envisage aussi une boucle à l'inférence avec un modèle de langage. Celui-ci proposerait de petits programmes formels décrivant de nouvelles dynamiques. Un vérificateur de modèles (model checker) les testerait et renverrait un contre-exemple ou une incohérence structurelle en cas d'erreur. Le modèle de langage réviserait son hypothèse, le robot collecterait des données ciblées, et le cycle recommencerait. Selon la formule de Delgrange, le modèle de langage propose et le vérificateur formel contrôle.
Systèmes multi-agents
Le problème se complique avec plusieurs agents, car chaque apprenant fait partie de l'environnement de tous les autres. Les dynamiques effectives changent quand les agents mettent à jour leurs politiques, arrivent ou partent, partagent des informations ou adoptent de nouveaux objectifs. Delgrange suggère qu'un modèle du monde fondationnel pourrait relier chaque politique locale aux hypothèses qui sous-tendent son certificat. Si un robot modifie son itinéraire, le système pourrait identifier les garanties touchées, collecter des données si nécessaire et ne réviser que ces composants, au lieu de revérifier toute la flotte. Les défaillances s'accompagneraient d'un contre-exemple indiquant quelle interaction a rompu un certificat.
Il désigne le passage à l'échelle comme principal obstacle. L'espace d'états conjoint croît rapidement avec le nombre d'agents, et les garanties locales ne se composent pas automatiquement en une garantie globale.
Analyse : ce que cela établit, et ce que cela n'établit pas
Le prix récompense une direction de recherche, et l'article ne rapporte aucun système opérationnel. Delgrange affirme que les briques existent déjà : traductions formelles de récompenses, abstractions vérifiables, méthodes d'amélioration sûre des politiques et génération de programmes. Ce qui manque, c'est un agent de bout en bout efficace qui maintient le tout calibré pendant qu'il apprend. C'est un constat sur l'intégration, et c'est souvent là que ce type de programme cale.
L'idée compte parce qu'elle change le critère d'évaluation d'un modèle du monde. Les modèles actuels sont optimisés pour bien prédire en moyenne. L'exemple de l'entrepôt montre pourquoi cela peut échouer pour des garanties de sécurité : une petite erreur sur une seule transition peut invalider une garantie que la moyenne masque. Intégrer au modèle une information de fiabilité, liée à une politique et à une exigence précises, constitue un critère plus exigeant que la précision prédictive. Cela revient aussi à traiter la certification comme un travail continu, ce qui convient aux déploiements où les conditions dérivent.
Face aux deux traditions qu'elle réunit, la proposition conserve le passage à l'échelle de l'apprentissage par renforcement et les garanties de correction explicites de la synthèse réactive, mais elle dépend d'un élément que ni l'une ni l'autre ne fournit : une mesure fiable du moment où une abstraction apprise est assez bonne pour soutenir une conclusion formelle. La description de l'article ne permet pas de dire si ce calibrage peut être assez fin pour être utile sans devenir si conservateur que le vérificateur rejette la plupart des mises à jour.
Plusieurs affirmations restent non démontrées. Aucun résultat ne prouve que la vérification puisse s'exécuter assez vite pour influencer l'apprentissage en ligne. Aucun résultat ne montre que des programmes proposés par un modèle de langage et contrôlés par un model checker convergent en pratique vers des dynamiques correctes. Et pour le multi-agent, Delgrange reconnaît lui-même qu'il reste à trouver des méthodes préservant la correction (soundness) lors de la composition. Tant que ces points ne sont pas démontrés, les modèles du monde fondationnels se lisent surtout comme un cahier des charges bien argumenté pour des agents adaptatifs sûrs ; la prochaine preuve à guetter serait un prototype qui boucle la boucle, ne serait-ce que sur une petite tâche à l'échelle d'un entrepôt.