Generalist asegura que su modelo base de robótica GEN-1.5 puede aprender una nueva tarea física en segundos a partir de un único ejemplo, sin actualizaciones de gradiente ni ajuste fino (fine-tuning). La empresa lo describe como aprendizaje robótico de un solo intento (one-shot) y afirma que es el primer modelo que conoce en el que el aprendizaje de habilidades físicas con uno o pocos ejemplos surge a gran escala.
Qué afirma Generalist
GEN-1.5 es el último modelo base de robótica de la compañía. Generalist plantea el resultado a partir de una capacidad humana: las personas pueden adquirir nuevas habilidades físicas con uno o pocos ejemplos. La empresa sostiene que GEN-1.5 muestra los primeros indicios de esa misma capacidad.
El modelo aprende a partir de demostraciones. Exhibe una amplia capacidad de aprendizaje con un solo ejemplo (one-shot) y con pocos ejemplos (few-shot), y también muestra generalización física de cero intentos (zero-shot), es decir, resuelve algunas situaciones sin haber visto ningún ejemplo. Generalist indica que el aprendizaje ocurre sin actualizaciones de gradiente ni ajuste fino, por lo que los pesos del modelo no se reentrenan para cada nueva tarea.
La compañía es transparente sobre los límites. Las tareas son sencillas y de horizonte corto. Generalist presenta el trabajo como un paso importante hacia su misión declarada de construir inteligencia general para el mundo físico, no como una capacidad terminada.
Hay una salvedad sobre la novedad del resultado. En muchas tareas en las que el modelo parecía resolver algo por sí solo, la entrada del blog de Generalist solo puede decir que no existían datos de preentrenamiento relevantes "hasta donde sabemos". Es una declaración de creencia sobre el conjunto de entrenamiento, no una exclusión verificada.
Otros trabajos destacados de la semana
GEN-1.5 fue una de varias demostraciones de investigación y producto del resumen semanal de videos de robótica. Las demás tuvieron un alcance más acotado.
Unitree publicó un video de una actuación de sus robots que generó una pregunta con ironía sobre su uso comercial. La conjetura fue el reparto de paquetes a alta velocidad y alto riesgo en ventanas de segundos pisos.
Un equipo del Istituto Italiano di Tecnologia presentó BeanBot, un robot inspirado en los frijoles saltarines mexicanos. AgileX Robotics mostró un grupo de robots bateristas.
El AIMS Group de la Universidad Politécnica de Hong Kong y el DRAGON Lab de la Universidad de Tokio describieron un marco de optimización de trayectorias para robots aéreos. Lo presentan como el primero basado en programación convexa secuencial para multirrotores generalizados, que abarca plataformas convencionales y omnidireccionales. El objetivo es recorrer una secuencia de poses arbitrarias de forma rápida, precisa y continua. El equipo optó por un modelo analítico basado en primeros principios en lugar de aprender el comportamiento a partir de datos.
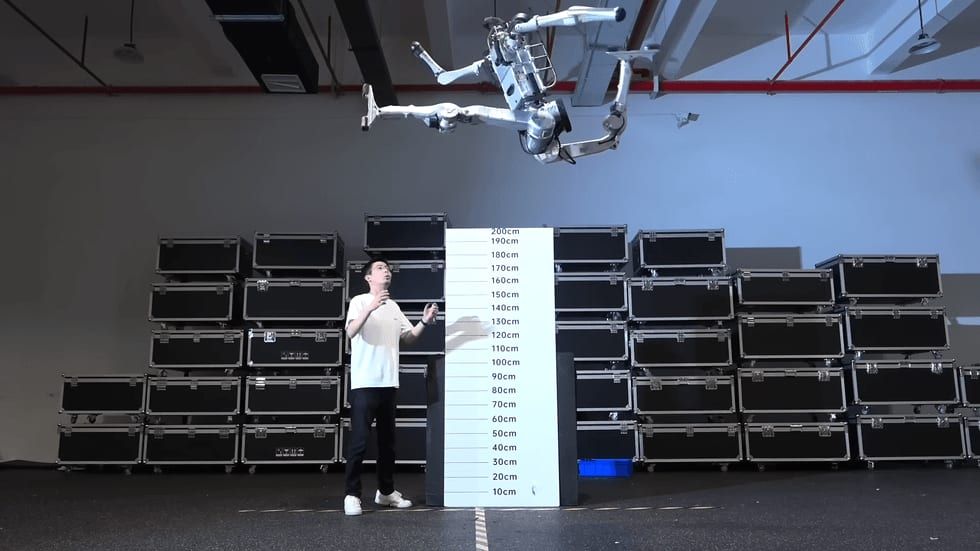
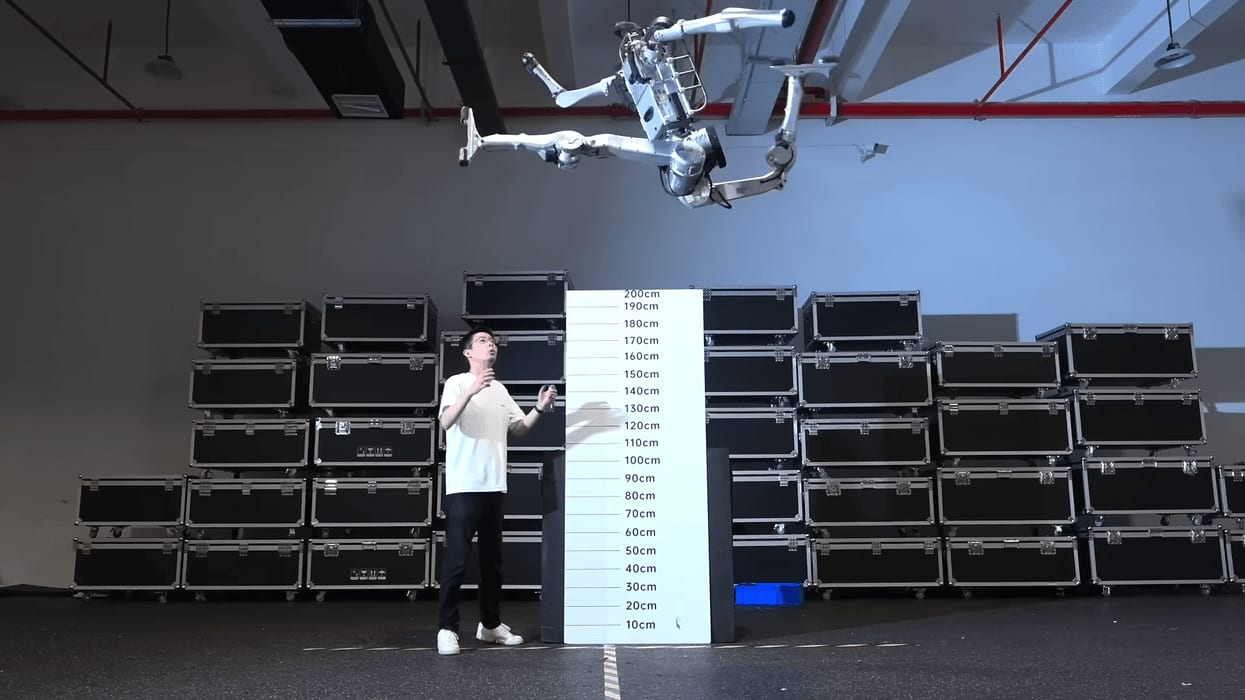
Otro grupo, EVARL, describió un enfoque basado en aprendizaje para la braquiación, la locomoción por balanceo de los simios. Su método se llama aprendizaje por refuerzo guiado por puntos de referencia (waypoints). Guía al efector final a través de esos puntos mientras el aprendizaje por refuerzo explora el movimiento de todo el cuerpo. La política aprendida resolvió recorridos con distintas alturas, separaciones y orientaciones de barras en experimentos de simulación a simulación (sim-to-sim). En el mundo real, un robot de dos brazos de tamaño humano recorrió cuatro barras consecutivas.
Gravis Robotics promocionó Gravis Rack, un kit de actualización que convierte maquinaria hidráulica comercial en robots. Incorpora cámaras, lidar y cómputo a bordo, además de control basado en aprendizaje pensado para que la máquina trabaje cerca de sus límites y mueva más tierra con ciclos completos y rápidos.
Kawasaki mostró un enfoque distinto de soldadura robótica en astilleros. Flexiv presentó un robot agrícola. PHYBOT mostró un clip con temática de árbitro. Zhejiang Humanoid presentó humanoides para el hogar. SRI compartió imágenes de Shakey the Robot.
TS-Robotics describió un método de interacción física humano-robot que utiliza los sensores de par de las articulaciones de robots colaborativos estándar. Una superficie táctil pasiva de plexiglás, sin instrumentación, se monta en la brida del robot y lo convierte en una interfaz de entrada basada en escritura a mano. El MIT mostró una interfaz del tipo que suele usarse para entrenar robots, adaptada para entrenar a personas.
Próximos eventos
Humanoids Summit Seúl se celebra el 22 y 23 de septiembre de 2026 en Seúl. IROS 2026 tendrá lugar del 27 de septiembre al 1 de octubre de 2026 en Pittsburgh. CoRL 2026 se realizará del 9 al 12 de noviembre de 2026 en Austin.
Por qué importa y qué falta por demostrar
El elemento más relevante es GEN-1.5, porque apunta a un costo que limita el despliegue de robots. La mayoría de los flujos de aprendizaje robótico requieren recopilar datos, entrenar o hacer ajuste fino para cada nueva tarea. Un modelo que se adapta a partir de una sola demostración, sin tocar sus pesos, trasladaría ese trabajo al momento de uso. Es la misma propiedad que hizo útil el aprendizaje en contexto en los modelos de lenguaje, y Generalist afirma haber logrado una versión física temprana de ella.
La comparación con otros trabajos de la semana es ilustrativa. El trabajo del DRAGON Lab y PolyU resuelve la secuenciación de poses aéreas con un modelo analítico y sin datos de entrenamiento. El trabajo de braquiación de EVARL usa aprendizaje por refuerzo, y su resultado más exigente son cuatro barras reales con un robot de tamaño humano. Ambos son concretos, acotados y medidos. GEN-1.5 es más ambicioso, pero la evidencia descrita está menos cuantificada: la fuente no ofrece tasas de éxito, número de tareas ni el hardware del robot.
Varios puntos siguen sin demostrarse. Primero, las tareas son sencillas y de horizonte corto, por lo que se desconoce si el aprendizaje robótico con un solo ejemplo se sostiene en secuencias largas donde los errores se acumulan. Segundo, la salvedad sobre los datos de preentrenamiento implica que una supuesta habilidad nueva podría estar más cerca de la distribución de entrenamiento de lo que parece. Tercero, no se ha descrito ninguna evaluación independiente ni una comparación con modelos de referencia ajustados (fine-tuned) en las mismas tareas.
Nada de esto invalida la afirmación. Define el nivel de exigencia para la próxima ronda de evidencia: tasas de éxito publicadas, datos de entrenamiento claramente documentados y pruebas en tareas que duren más de unos pocos segundos. Hasta entonces, GEN-1.5 se interpreta mejor como una señal temprana y creíble de que el aprendizaje robótico con un solo ejemplo puede surgir a gran escala, no como prueba de que se generaliza al trabajo real.