Un veicolo che usa UNCAP riceve un breve messaggio di testo come "veicolo in immissione da destra, a circa 15 metri, in rapido avvicinamento" e lo tratta come un'osservazione che i suoi stessi sensori non avrebbero potuto fare. In simulazione, questo approccio ai veicoli autonomi cooperativi ha ridotto del 63% la banda di comunicazione e migliorato del 31% i punteggi di guida rispetto ai precedenti schemi basati sul linguaggio e ai veicoli che non comunicano.
Il framework arriva da un team guidato da Neel P. Bhatt, con coautori tra cui Po-han Li, Sandeep P. Chinchali, David Fridovich-Keil, Zhangyang Wang e Ufuk Topcu. L'articolo scientifico, intitolato UNCAP: Uncertainty-Guided Neurosymbolic Planning Using Natural Language Communication for Cooperative Autonomous Vehicles, è stato candidato al premio per il miglior paper di AAMAS 2026.
Perché il linguaggio al posto dei dati dei sensori
La strada tradizionale per la cooperazione tra veicoli è lo scambio di immagini grezze delle telecamere, nuvole di punti LiDAR o misurazioni radar. Secondo gli autori di UNCAP, questo approccio è difficile da portare su larga scala. I flussi grezzi consumano molta banda e richiedono un'elevata potenza di calcolo per essere elaborati. Inoltre presuppongono che ogni veicolo disponga di hardware di sensing comparabile, cosa che non sarà vera su strade condivise da molti costruttori, configurazioni di sensori e stack software.
Il linguaggio naturale aggira questi presupposti. Un messaggio come "pedone che attraversa dietro l'autobus" è leggero, non dipende da alcun sensore specifico e può essere letto da un modello visione-linguaggio. La difficoltà è che un veicolo a un incrocio trafficato può avere dieci o venti vicini. Deve decidere quali ascoltare e a quali credere quando due descrizioni sono in conflitto.
Le quattro fasi
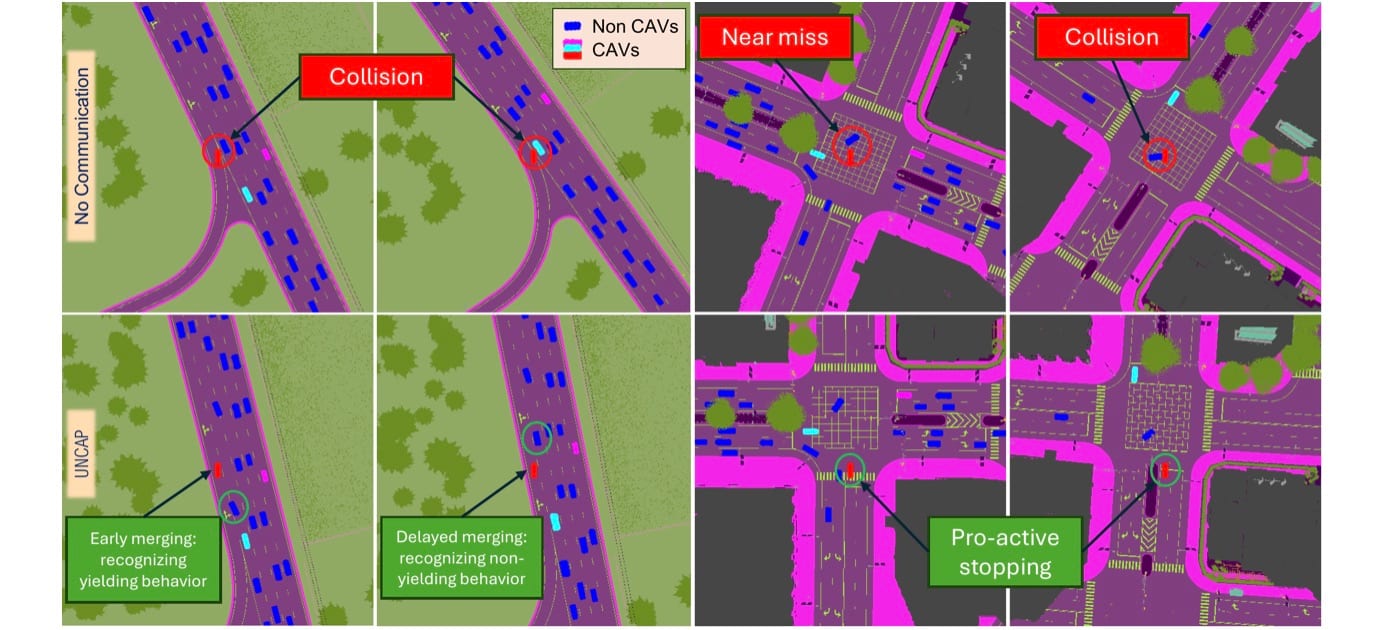
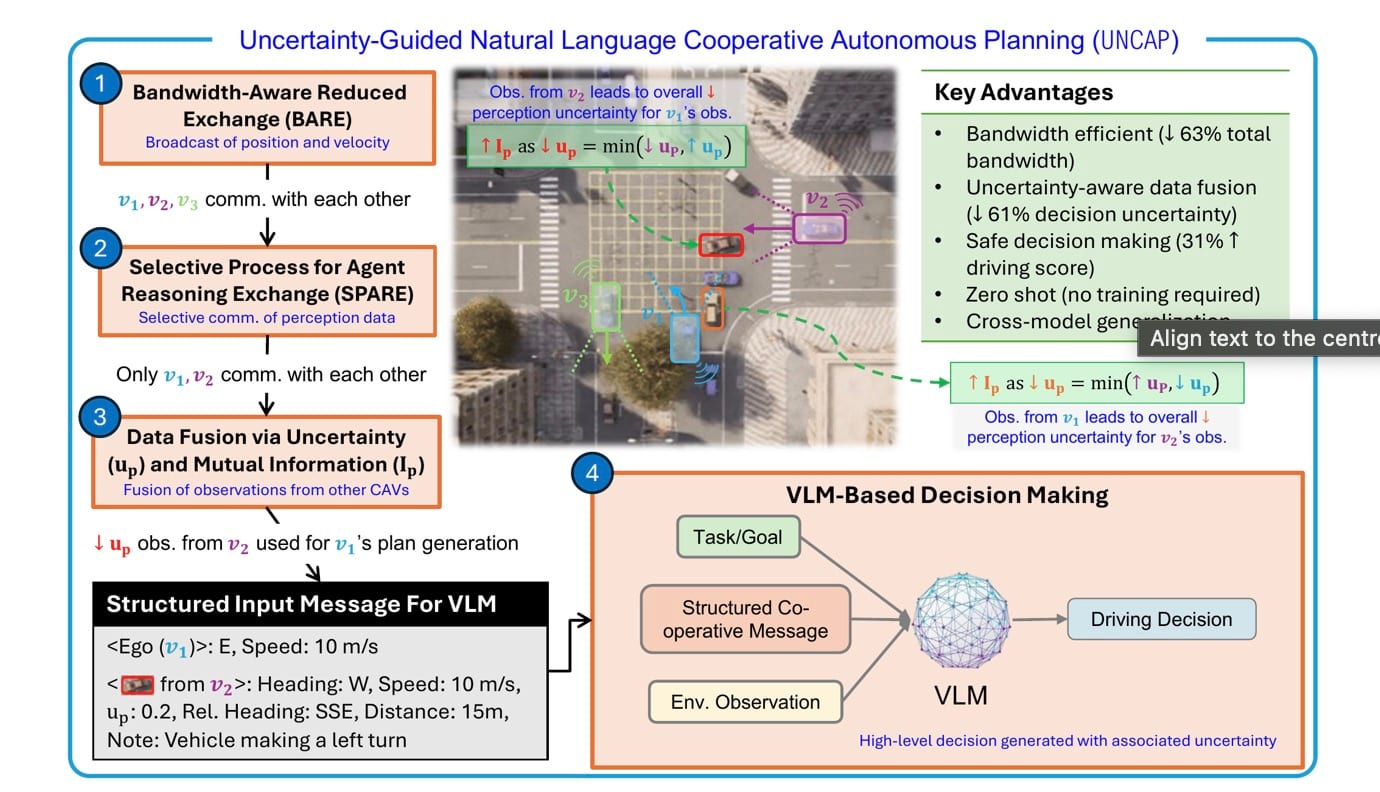
UNCAP funziona in modalità zero-shot. Non addestra alcun nuovo modello: si appoggia a modelli visione-linguaggio esistenti, aggiungendo sopra un livello di comunicazione. Il processo si articola in quattro fasi.
Primo, ogni veicolo trasmette un segnale periodico (heartbeat) contenente solo posizione e direzione di marcia. L'heartbeat pesa pochi byte e segnala ai veicoli vicini chi si trova nei paraggi.
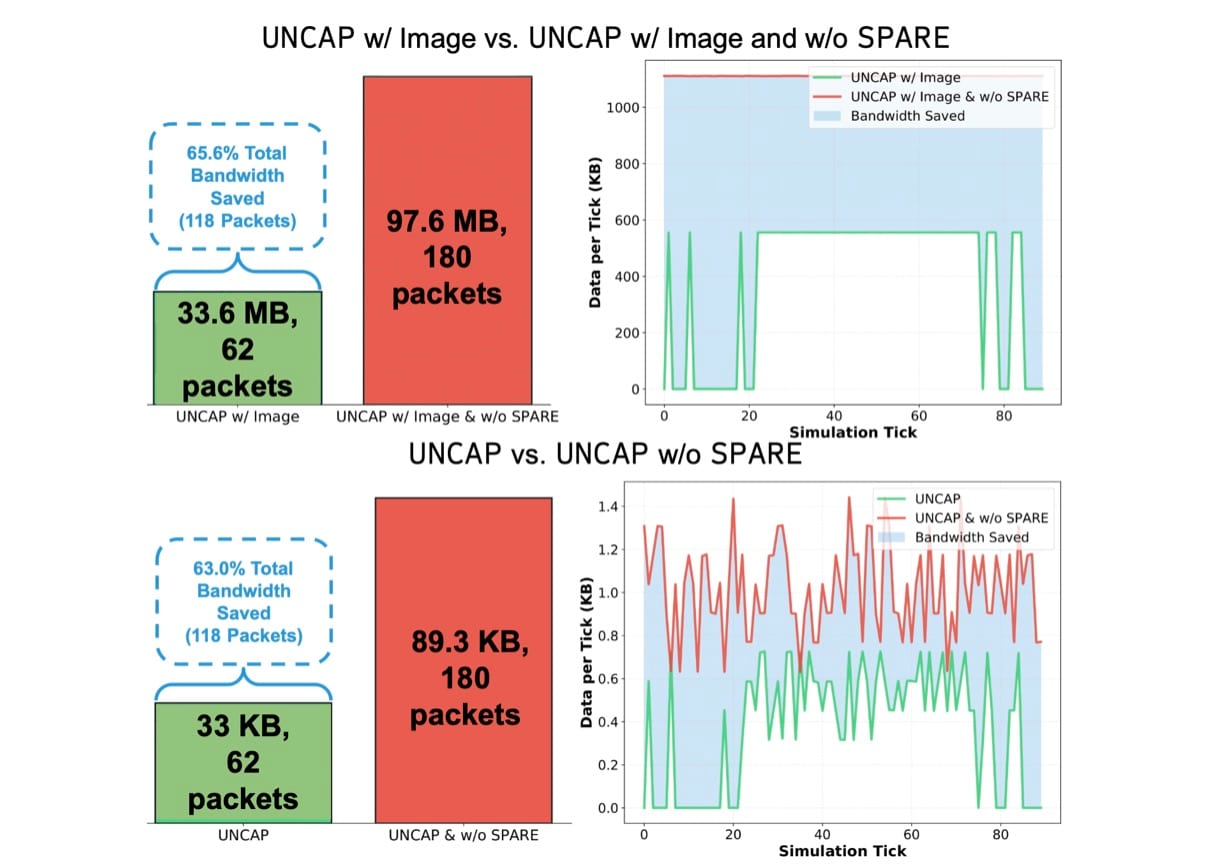
Secondo, il veicolo decide quali vicini contano. Seleziona quelli abbastanza vicini e con probabili effetti sulla sua traiettoria futura. Un'auto che si allontana da un incrocio viene scartata, mentre una che si avvicina allo stesso incrocio viene mantenuta. Questo passaggio riduce le comunicazioni superflue e il calcolo richiesto nelle fasi successive, il che secondo gli autori permette al sistema di gestire gruppi numerosi di veicoli.
Terzo, i veicoli selezionati descrivono ciò che vedono in linguaggio naturale, insieme a stime di confidenza. Queste stime sono calibrate con la conformal prediction, un metodo leggero pensato per far sì che i valori di confidenza riflettano l'effettiva affidabilità dell'informazione. Il veicolo ricevente misura poi l'informazione mutua che ciascun messaggio apporta. I messaggi che chiariscono meglio la scena ricevono più peso, mentre quelli poco informativi o potenzialmente fuorvianti vengono ridimensionati.
Quarto, la descrizione combinata della scena viene passata a un modello visione-linguaggio già pronto all'uso. Il modello restituisce una decisione di guida, come immettersi, attendere o dare la precedenza, con un punteggio di confidenza.
Cosa hanno mostrato i test
Il team ha valutato UNCAP nel simulatore di guida CARLA usando il benchmark OPV2V, che comprende immissioni in autostrada, incroci urbani e altre scene in cui le occlusioni sono frequenti. Rispetto ai veicoli che non comunicano e ai precedenti approcci basati sul linguaggio, che trasmettevano ogni osservazione a tutte le auto, UNCAP ha migliorato sia l'efficienza sia la sicurezza.
I risultati dichiarati sono: 63% di banda di comunicazione in meno, punteggio di guida più alto del 31%, incertezza decisionale inferiore del 61% e margini di sicurezza quattro volte maggiori negli eventi di quasi-collisione.
Un risultato è andato contro le attese: condividere immagini grezze ha dato prestazioni peggiori rispetto alla condivisione di linguaggio. Gli autori ipotizzano che gli attuali modelli visione-linguaggio facciano fatica a ragionare congiuntamente su più flussi video ripresi da punti di vista diversi. Convertire prima ogni vista in una descrizione concisa sembra funzionare come una forma di ragionamento strutturato, che distilla le informazioni chiave prima che arrivino al modello decisionale.
I miglioramenti si sono mantenuti con diversi modelli di base: GPT-4o, GPT-4.1, GPT-4o-mini e GPT-5. Gli autori leggono questo dato come prova che il vantaggio deriva dalla strategia di comunicazione e non da un singolo modello.
Limiti e significato del risultato
Gli autori dichiarano le principali limitazioni. Tutti gli esperimenti sono stati condotti in simulazione, quindi sensori rumorosi, collegamenti wireless inaffidabili, ritardi di rete e perdita di pacchetti non sono stati testati. Interrogare un modello visione-linguaggio richiede circa un secondo, per cui le decisioni vengono prese in momenti chiave e non in modo continuo.
Questi limiti definiscono fin dove si può spingere la lettura del risultato. Il dato del 63% di banda confronta UNCAP con schemi che trasmettono tutto. Dimostra che una messaggistica selettiva e calibrata batte quella indiscriminata. Non dimostra come il sistema si comporti quando i messaggi arrivano in ritardo, vanno persi o sono corrotti. Anche la ponderazione della fiducia basata sull'informazione mutua è qui testata solo su vicini simulati, e la fonte non descrive come il sistema gestisca un veicolo che invia descrizioni false con un'elevata confidenza dichiarata.
Il risultato sulle immagini grezze è il più rilevante per il settore, ma anche il meno consolidato. Se le sintesi in linguaggio aiutano perché i modelli ragionano male su più punti di vista, il vantaggio potrebbe ridursi con il miglioramento dei modelli multi-vista. La coerenza tra quattro varianti di GPT suggerisce che l'effetto non dipenda da un singolo modello, ma tutte e quattro appartengono alla stessa famiglia. La fonte non riporta test su altre famiglie di modelli.
La scelta progettuale che merita attenzione è la separazione tra con chi parlare e quanto fidarsi. I lavori precedenti sulla guida cooperativa si concentravano sulla condivisione dei dati dei sensori, che vincola i veicoli a hardware compatibile. Un canale testuale indipendente dall'hardware, con incertezza esplicita, si adatta alle condizioni di flotte miste descritte dagli autori. Resta da dimostrare se regga alle reali condizioni wireless e ai requisiti di latenza del controllo continuo. Gli autori indicano come possibili applicazioni anche flotte di robot, droni e agenti software, ma il paper valuta soltanto la guida. Per ora UNCAP è un risultato di simulazione per i veicoli autonomi cooperativi, che mostra come la messaggistica selettiva in linguaggio naturale meriti di essere provata su strada.