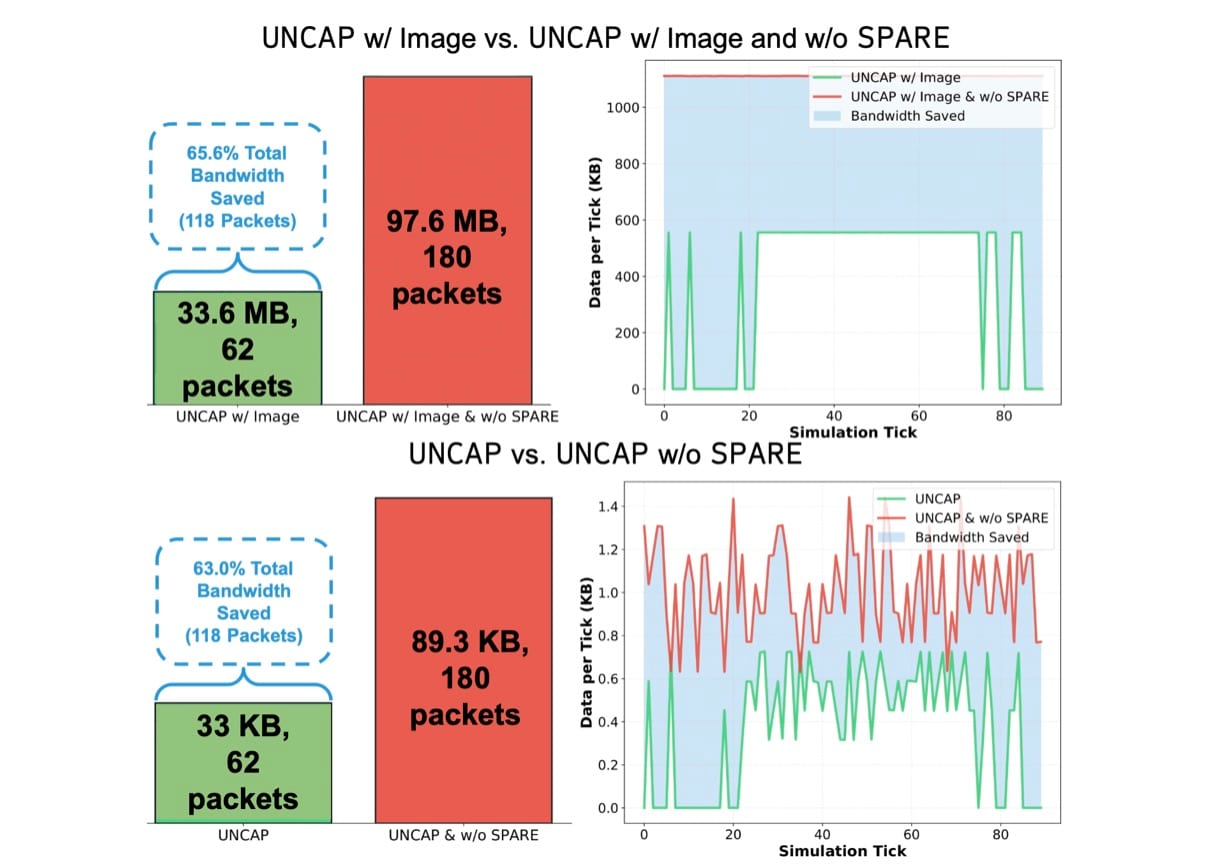
Un véhicule équipé d'UNCAP reçoit un court message texte, par exemple « véhicule qui s'insère par la droite, à environ 15 mètres, à vive allure », et le traite comme une observation que ses propres capteurs n'auraient pas pu faire. En simulation, cette approche des véhicules autonomes coopératifs a réduit la bande passante de communication de 63 % et amélioré les scores de conduite de 31 % par rapport aux systèmes antérieurs fondés sur le langage et aux véhicules qui ne communiquent pas.
Ce cadre est issu d'une équipe dirigée par Neel P. Bhatt, avec notamment pour coauteurs Po-han Li, Sandeep P. Chinchali, David Fridovich-Keil, Zhangyang Wang et Ufuk Topcu. L'article, intitulé UNCAP: Uncertainty-Guided Neurosymbolic Planning Using Natural Language Communication for Cooperative Autonomous Vehicles, a été nominé pour le prix du meilleur article d'AAMAS 2026.
Pourquoi le langage plutôt que les données de capteurs
La voie classique de la coopération entre véhicules consiste à échanger des images brutes de caméra, des nuages de points LiDAR ou des mesures radar. Les auteurs d'UNCAP estiment qu'elle est difficile à déployer à grande échelle. Les flux bruts consomment beaucoup de bande passante et exigent une forte puissance de calcul. Ils supposent aussi que chaque véhicule dispose de capteurs comparables, ce qui ne sera pas le cas sur des routes partagées entre de nombreux constructeurs, configurations de capteurs et architectures logicielles.
Le langage naturel écarte ces hypothèses. Un message comme « piéton qui traverse derrière le bus » est léger, ne dépend d'aucun capteur en particulier et peut être lu par un modèle vision-langage. La difficulté est qu'à une intersection très fréquentée, un véhicule peut avoir dix ou vingt voisins. Il doit décider lesquels écouter et lesquels croire lorsque deux descriptions se contredisent.
Les quatre étapes
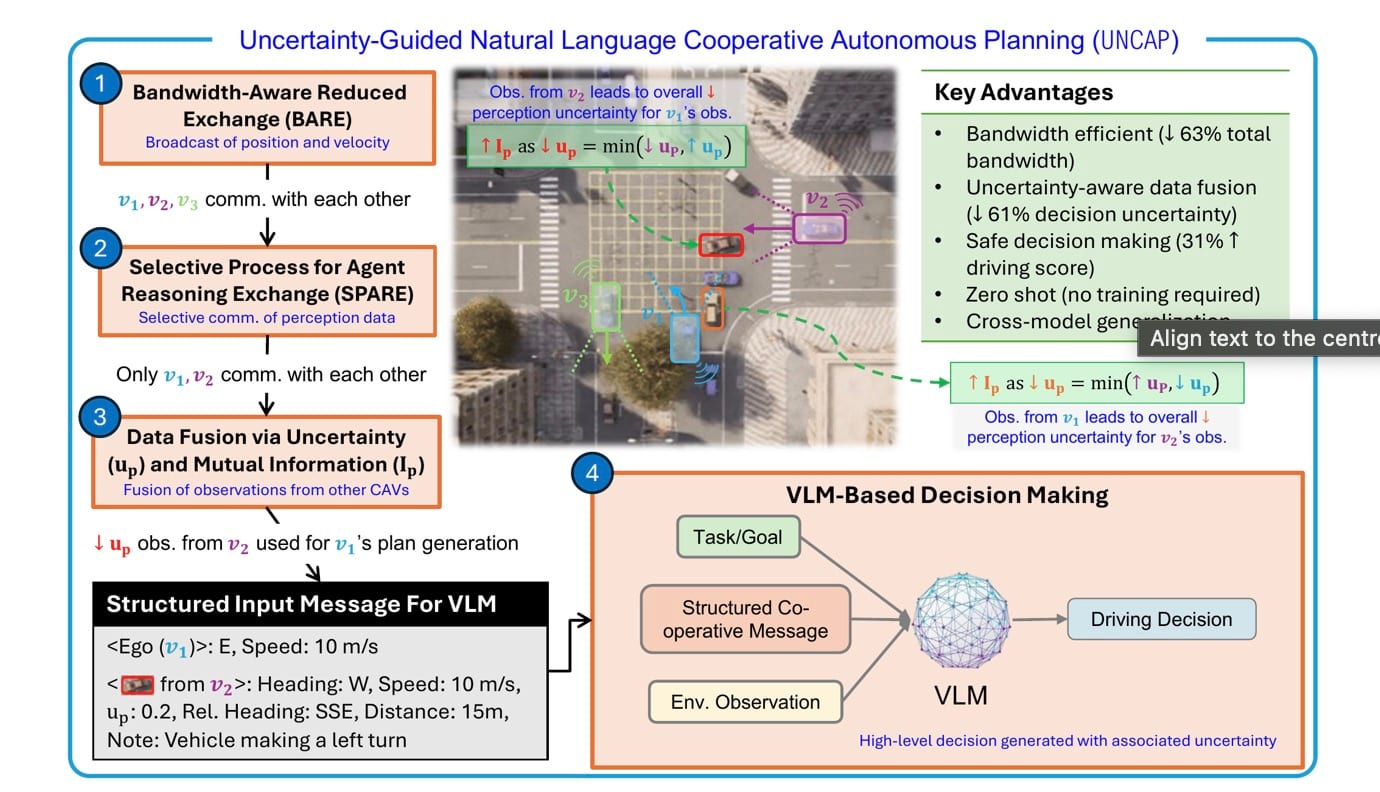
UNCAP fonctionne en zero-shot : aucun nouveau modèle n'est entraîné. Le système s'appuie sur des modèles vision-langage existants, auxquels il ajoute une couche de communication. Le processus comporte quatre étapes.
D'abord, chaque véhicule diffuse un signal périodique (« heartbeat ») qui ne contient que sa position et sa direction de déplacement. Ce signal ne pèse que quelques octets et indique aux véhicules proches qui se trouve dans les parages.
Ensuite, le véhicule détermine quels voisins comptent. Il retient ceux qui sont suffisamment proches et susceptibles d'influencer sa trajectoire future. Une voiture qui s'éloigne d'une intersection est écartée, tandis qu'une autre qui s'approche de la même intersection est conservée. Cette étape limite les échanges inutiles et le calcul nécessaire aux étapes suivantes, ce qui, selon les auteurs, permet au système de gérer de grandes flottes.
Troisièmement, les véhicules sélectionnés décrivent en langage naturel ce qu'ils perçoivent, accompagné d'estimations de confiance. Celles-ci sont calibrées par prédiction conforme, une méthode légère censée faire en sorte que les valeurs de confiance reflètent la fiabilité réelle de l'information. Le véhicule récepteur mesure ensuite l'information mutuelle apportée par chaque message. Les messages qui clarifient la scène reçoivent plus de poids, tandis que ceux qui n'apportent rien ou risquent d'induire en erreur sont minorés.
Enfin, la description combinée de la scène est transmise à un modèle vision-langage du commerce. Celui-ci renvoie une décision de conduite, comme s'insérer, attendre ou céder le passage, assortie d'un score de confiance.
Ce que les essais ont montré
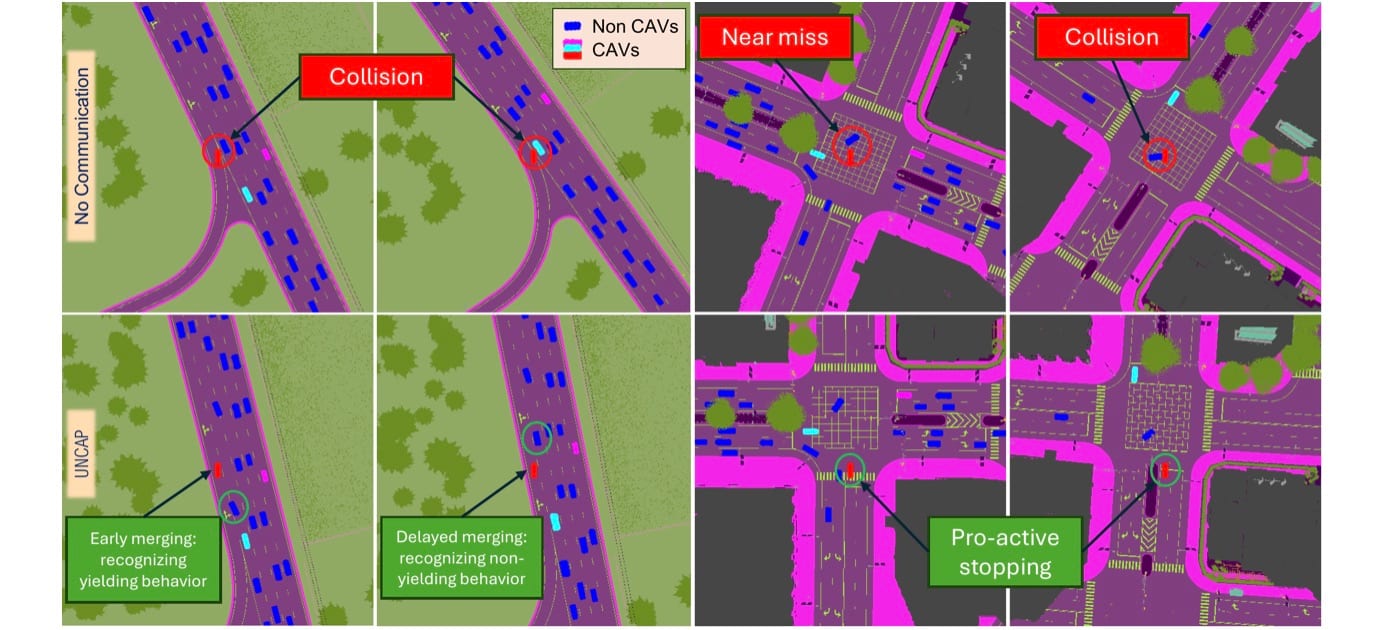
L'équipe a évalué UNCAP dans le simulateur de conduite CARLA avec le benchmark OPV2V, qui comprend des insertions sur autoroute, des intersections urbaines et d'autres scènes où les occultations sont fréquentes. Face aux véhicules non communicants et aux approches antérieures fondées sur le langage, qui diffusent chaque observation à tous les véhicules, UNCAP améliore à la fois l'efficacité et la sécurité.
Les gains rapportés sont une bande passante de communication réduite de 63 %, un score de conduite supérieur de 31 %, une incertitude de décision inférieure de 61 % et des marges de sécurité multipliées par quatre lors des situations de quasi-collision.
Un résultat va à l'encontre des attentes : le partage d'images brutes s'est révélé moins performant que le partage de langage. Les auteurs avancent que les modèles vision-langage actuels peinent à raisonner conjointement sur plusieurs flux de caméras pris sous des angles différents. Convertir d'abord chaque vue en une description concise semble agir comme une forme de raisonnement structuré, en distillant l'information essentielle avant qu'elle n'atteigne le modèle de décision.
Les améliorations se sont maintenues sur plusieurs modèles sous-jacents : GPT-4o, GPT-4.1, GPT-4o-mini et GPT-5. Les auteurs y voient la preuve que le bénéfice vient de la stratégie de communication et non d'un modèle en particulier.
Limites et portée du résultat
Les auteurs exposent les principales limites. Toutes les expériences ont été menées en simulation : les capteurs bruités, les liaisons sans fil peu fiables, les retards réseau et les pertes de paquets n'ont donc pas été testés. L'interrogation d'un modèle vision-langage prend environ une seconde, de sorte que les décisions sont prises à des moments clés et non en continu.
Ces limites bornent la portée du résultat. Le chiffre de 63 % de bande passante compare UNCAP à des systèmes qui diffusent tout à tout le monde. Il montre qu'une communication sélective et calibrée l'emporte sur une communication indiscriminée. Il ne dit pas comment le système se comporte quand les messages arrivent en retard, sont perdus ou sont corrompus. La pondération de la confiance par l'information mutuelle n'est elle aussi testée ici que face à des voisins simulés, et la source ne décrit pas la façon dont le système traite un véhicule qui enverrait de fausses descriptions avec une confiance affichée élevée.
Le résultat sur les images brutes est le constat le plus lourd de conséquences pour le domaine, mais aussi le moins établi. Si les résumés en langage aident parce que les modèles raisonnent mal sur plusieurs points de vue, cet avantage pourrait s'amenuiser à mesure que les modèles multivues progressent. La cohérence observée sur quatre variantes de GPT laisse penser que l'effet n'est pas lié à un seul modèle, mais les quatre appartiennent à la même famille. La source ne fait état d'aucun test sur d'autres familles.
Le choix de conception qui mérite l'attention est la séparation entre « à qui parler » et « dans quelle mesure faire confiance ». Les travaux antérieurs sur la conduite coopérative se concentraient sur le partage de données de capteurs, ce qui lie les véhicules à du matériel compatible. Un canal texte indépendant du matériel, avec une incertitude explicite, correspond aux conditions de flottes hétérogènes décrites par les auteurs. Reste à prouver qu'il résiste aux conditions réelles des communications sans fil et aux exigences de latence d'un contrôle continu. Les auteurs évoquent aussi les flottes de robots, les drones et les agents logiciels comme applications possibles, mais l'article n'évalue que la conduite. Pour l'instant, UNCAP est un résultat de simulation pour les véhicules autonomes coopératifs, qui montre que la messagerie sélective en langage naturel mérite d'être testée sur route réelle.