SceneSmith, un sistema sviluppato da MIT CSAIL e Toyota Research Institute, genera scene 3D di interni grazie a tre agenti di IA che si basano tutti sul modello visione-linguaggio GPT-5.2. Le scene si caricano direttamente nei software di simulazione fisica e fungono da ambienti di simulazione per l'addestramento dei robot, tra cui ristoranti, camere da letto e hotel. Il team ne ha realizzate oltre 1.300.
Il lavoro affronta un collo di bottiglia sul fronte dei dati. I robot imparano meglio dall'esperienza, ma insegnare fisicamente molte azioni in molti contesti richiede tempo e manodopera. La simulazione è un sostituto naturale. Russ Tedrake, ricercatore principale al CSAIL, osserva che i motori fisici sono migliorati in modo significativo negli ultimi anni. La sfida ancora aperta, spiega, è creare contenuti di simulazione abbastanza ricchi e vari da catturare la complessità del mondo reale.
Tre agenti, una scena
Ogni agente ha un ruolo preciso. Un agente progettista genera gli elementi della scena. Un agente critico valuta se l'insieme appare realistico e funzionale. Un agente orchestratore gestisce lo scambio tra i due e decide quando il progetto è concluso. Poiché ciascun agente si appoggia allo stesso modello visione-linguaggio, addestrato su enormi quantità di testi e immagini dal web, tutti possiedono una certa conoscenza spaziale di come sono organizzati i luoghi di tutti i giorni.
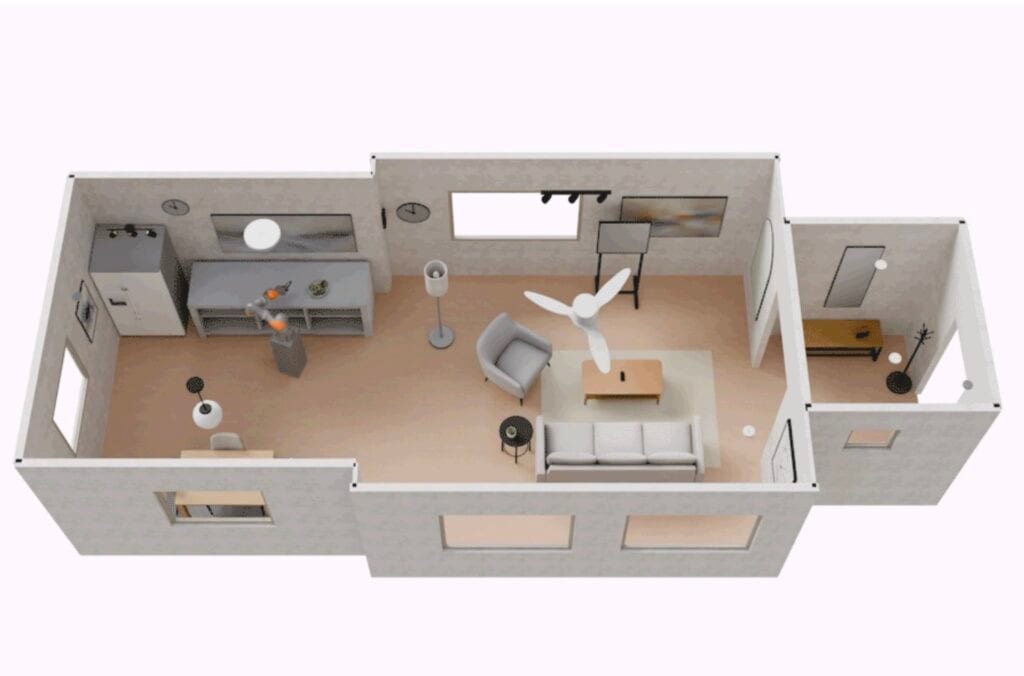
Il processo procede per fasi, un po' come disegnare una planimetria e poi arredarla. Il progettista parte da una disposizione generale, il critico la rivede e l'orchestratore dà il via libera. Gli agenti ripetono il ciclo per i mobili, poi per gli oggetti su pareti e soffitti e infine per gli elementi che un robot può manipolare. Il critico potrebbe, per esempio, suggerire di togliere una vasca da bagno da un soggiorno. L'orchestratore può far tornare il progetto indietro di diversi passaggi se l'aspetto visivo non è sufficientemente curato. Quando gli agenti hanno finito, il software di simulazione aggiunge la meccanica del mondo fisico.
L'utente può guidare il sistema con una richiesta come un garage con un'auto, un banco da lavoro, pneumatici impilati in un angolo e una scala appoggiata alla parete. Il sistema è in grado di creare anche singoli oggetti. Se gli si chiede un carrello di servizio con le ruote, genera un'immagine 2D e la trasforma in un modello dettagliato con massa, attrito e inerzia. Dato che gli asset vengono generati a partire dal testo, non sono vincolati a una libreria predefinita. Le scene includono oggetti articolati, come armadietti che un robot può aprire e chiudere, elementi che secondo i ricercatori mancavano spesso nei sistemi di riferimento precedenti.
Cosa hanno mostrato i test
Le scene di SceneSmith contengono fino a sei volte più oggetti rispetto a quelle dei metodi precedenti. Il team lo ha confrontato con i sistemi di riferimento per la generazione di scene HSM e Holodeck. SceneSmith ha prodotto ambienti con più oggetti, tra cui un ufficio privato, un negozio di ceramiche e una sala giochi a tema Minecraft.
Più di 200 utenti hanno inoltre messo a confronto i risultati. Hanno giudicato più realistico l'aspetto di SceneSmith in oltre il 90 percento dei casi. Hanno anche rilevato che, in genere, segue i prompt con maggiore fedeltà rispetto agli altri approcci.
Il realismo è difficile da dimostrare in modo diretto, per cui i ricercatori hanno provato diverse strade. Il test più significativo ha usato una policy robotica preaddestrata, un controllore di IA addestrato soprattutto su dati del mondo reale che non aveva mai visto una scena di SceneSmith. Quando gli è stato chiesto di prendere una mela da una ciotola e di posarla su un tagliere, il robot simulato ci è riuscito. I ricercatori sostengono che non sarebbe andata così se le scene fossero state troppo diverse dagli ambienti reali da cui la policy aveva imparato. Hanno anche teleoperato i robot negli spazi per aprire armadietti, riporre bottiglie e spostarsi tra le stanze, il che, a loro dire, mostra che gli ambienti reggono un'interazione fisica prolungata.
Il team ha usato le scene anche per valutare i piani d'azione. Ha testato diverse policy in 100 spazi distinti e un agente VLM ha giudicato ogni tentativo. L'agente ha rilevato difetti nei piani del robot, che spesso non riusciva a portare a termine i compiti. Gli esseri umani si sono trovati d'accordo con i giudizi del modello in oltre il 99 percento dei casi. I ricercatori ritengono che questo possa aiutare i roboticisti a scartare gli approcci difettosi prima che un robot si muova nel mondo reale.
Nicholas Pfaff, dottorando al MIT e primo autore, racconta che il sistema ha prodotto disposizioni creative e varie che lui non gli aveva suggerito nei prompt. Le scene si prestano ad attività di pratica come mettere una tazza nel lavandino, sistemare la frutta sui piatti e spostare una lattina di bibita da uno scaffale a un tavolo.
I limiti riconosciuti dal team
La velocità è il costo principale. Una singola scena può richiedere diverse ore, perché gli agenti creano e controllano con attenzione ogni oggetto. I ricercatori affermano che una maggiore potenza di calcolo potrebbe migliorare sensibilmente l'efficienza. Sperano inoltre di estendere il sistema agli oggetti deformabili, come le spugne, se diventeranno disponibili ampie librerie 3D.
Gli autori dello studio sono Pfaff e Tedrake, insieme a Thomas Cohn del MIT e ai roboticisti del Toyota Research Institute Sergey Zakharov e Rick Cory. Il sostegno è arrivato in parte da Amazon, dall'Office of Naval Research degli Stati Uniti, dal Toyota Research Institute e dalla National Science Foundation statunitense. Il team ha presentato il lavoro come spotlight alla International Conference on Machine Learning 2026.
Analisi: cosa cambia e cosa no
Il valore pratico sta nella scala e nella varietà. Le scene di simulazione costruite a mano sono costose da realizzare, e un prompt testuale che produce una stanza popolata e pronta per la fisica sposta quel costo dai progettisti umani al calcolo. La densità di oggetti dichiarata e la presenza di elementi articolati e manipolabili contano perché l'allenamento alla manipolazione richiede cose da aprire, afferrare e spostare. Su questi parametri, e rispetto a HSM e Holodeck, SceneSmith rappresenta un passo avanti nella ricchezza dei contenuti.
Restano però alcune questioni aperte. La prova più solida del realismo è una policy preaddestrata che porta a termine un compito nelle scene generate. La fonte descrive un solo esempio, quello della mela e del tagliere, e non fornisce un tasso di successo tra scene o compiti diversi. Questo sostiene l'idea che le scene somiglino a contesti reali, ma non dimostra che una policy addestrata al loro interno si comporti meglio su hardware fisico. La fonte non riporta questo test.
Il ciclo di valutazione si affida inoltre a un VLM. Gli esseri umani hanno concordato con i giudizi del modello in oltre il 99 percento dei casi, un risultato notevole. È stato però misurato su 100 spazi e su un insieme specifico di policy, quindi va considerato una verifica di quella configurazione e non una garanzia generale. L'intera pipeline dipende poi da un unico modello, GPT-5.2. Non viene riportato quanto funzioni bene con altri modelli.
L'altro vincolo è la velocità di produzione. Diverse ore per scena sono accettabili per costruire in anticipo una libreria di ambienti, ma limitano qualsiasi flusso di lavoro che richieda scene generate su richiesta. L'esclusione degli oggetti deformabili lascia inoltre fuori molti oggetti comuni di cucina e di casa. I miglioramenti dichiarati derivano da contenuti più ricchi, e nessun risultato dimostra che questo approccio di simulazione per l'addestramento dei robot abbia già ridotto i test nel mondo reale nella pratica, anche se i risultati sulla selezione delle policy vanno in quella direzione.