SceneSmith, un système développé par le MIT CSAIL et le Toyota Research Institute, génère des scènes 3D d'intérieur grâce à trois agents d'IA qui reposent tous sur le modèle vision-langage GPT-5.2. Les scènes se chargent directement dans les logiciels de simulation physique et servent d'environnements d'entraînement pour les robots : restaurants, chambres, hôtels, etc. L'équipe en a produit plus de 1 300.
Ces travaux visent un goulot d'étranglement sur les données. Les robots apprennent mieux par l'expérience, mais leur enseigner physiquement de nombreuses actions dans des environnements variés exige beaucoup de temps et de main-d'œuvre. La simulation est un substitut naturel. Russ Tedrake, chercheur principal au CSAIL, souligne que les moteurs physiques ont considérablement progressé ces dernières années. Le défi restant, selon lui, est de créer des contenus de simulation suffisamment riches et variés pour rendre compte de la complexité du monde réel.
Trois agents, une scène
Chaque agent a un rôle bien défini. Un agent concepteur génère les éléments d'une scène. Un agent critique indique si le rendu paraît réaliste et fonctionnel. Un agent orchestrateur gère les échanges entre les deux et décide quand la conception est terminée. Comme chacun s'appuie sur le même modèle vision-langage, entraîné sur d'immenses quantités de textes et d'images issus d'internet, chacun possède des connaissances spatiales sur l'agencement des lieux du quotidien.
Le processus se déroule par étapes, un peu comme on dessine un plan d'étage avant de le meubler. Le concepteur propose d'abord une disposition générale, le critique l'examine, puis l'orchestrateur la valide. Les agents répètent cette boucle pour le mobilier, puis pour les objets muraux et de plafond, et enfin pour les objets qu'un robot peut manipuler. Le critique peut, par exemple, recommander de retirer une baignoire d'un salon. L'orchestrateur peut renvoyer la conception plusieurs étapes en arrière si le rendu visuel n'est pas assez convaincant. Une fois le travail des agents terminé, le logiciel de simulation ajoute la mécanique du monde physique.
L'utilisateur peut saisir une requête du type : un garage avec une voiture, un établi, des pneus empilés dans un coin et une échelle contre le mur. Le système sait aussi créer des objets isolés. Si on lui demande un chariot de service à roulettes, il génère une image 2D, puis la transforme en modèle détaillé doté d'une masse, d'un coefficient de frottement et d'une inertie. Les ressources étant générées à partir du texte, elles ne se limitent pas à une bibliothèque figée. Les scènes comprennent des objets articulés, comme des placards qu'un robot peut ouvrir et fermer, ce qui faisait souvent défaut aux approches de référence précédentes, selon les chercheurs.
Ce que les tests ont montré
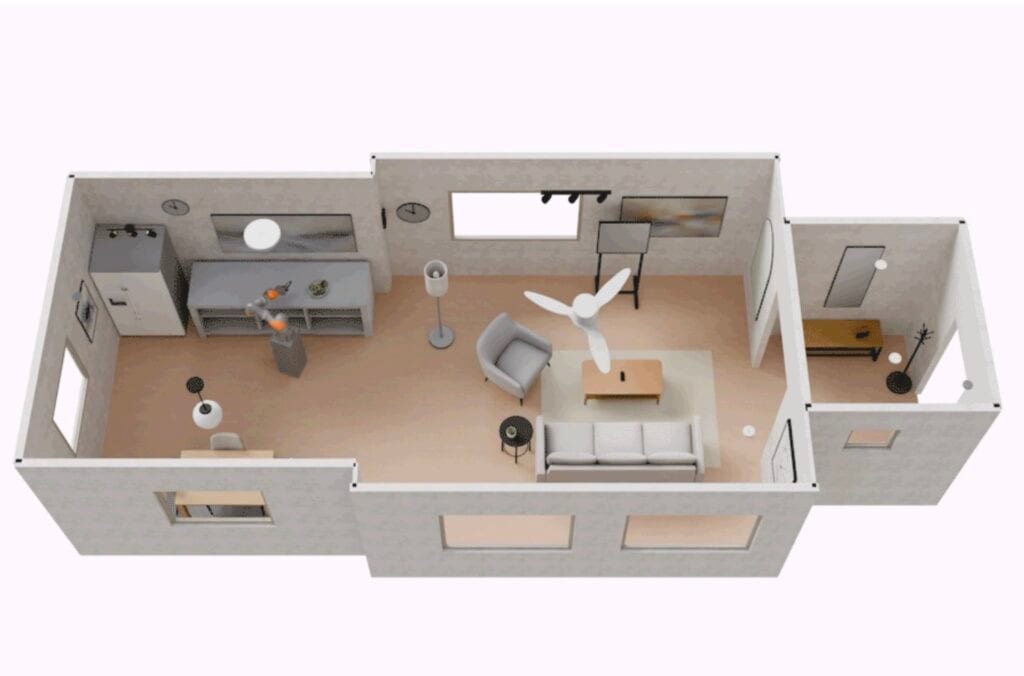
Les scènes de SceneSmith contiennent jusqu'à six fois plus d'objets que celles produites par les méthodes antérieures. L'équipe l'a comparé aux solutions de référence de génération de scènes HSM et Holodeck. SceneSmith a produit des environnements plus fournis en objets, notamment un bureau privé, une poterie-boutique et une salle de jeux sur le thème de Minecraft.
Plus de 200 utilisateurs ont également comparé les résultats. Ils ont jugé les visuels de SceneSmith plus réalistes dans plus de 90 % des cas. Ils ont aussi estimé qu'il respectait généralement mieux les instructions que les autres approches.
Le réalisme étant difficile à démontrer directement, les chercheurs ont multiplié les angles d'évaluation. Le test le plus révélateur a utilisé une politique de robot préentraînée, un contrôleur d'IA formé en grande partie sur des données du monde réel et qui n'avait jamais vu de scène SceneSmith. Chargé de prendre une pomme dans un bol et de la poser sur une planche à découper, le robot simulé y est parvenu. Les chercheurs estiment que cela n'aurait pas fonctionné si les scènes s'écartaient trop des environnements réels dont la politique s'est nourrie. Ils ont également téléopéré des robots dans ces espaces pour ouvrir des placards, ranger des bouteilles et passer d'une pièce à l'autre, ce qui, selon eux, montre que les environnements résistent à une interaction physique prolongée.
L'équipe a aussi utilisé les scènes pour évaluer des plans d'action. Elle a testé différentes politiques dans 100 espaces distincts, chaque tentative étant jugée par un agent VLM. Celui-ci a trouvé les plans du robot défaillants, la machine échouant souvent dans ses tâches. Les humains étaient d'accord avec les verdicts du modèle plus de 99 % du temps. Selon les chercheurs, cela pourrait aider les roboticiens à écarter les approches défectueuses avant que le robot n'agisse dans le monde réel.
Nicholas Pfaff, doctorant au MIT et premier auteur, explique que le système a produit des agencements créatifs et variés qu'il ne lui avait pas suggérés dans ses requêtes. Les scènes conviennent à des tâches d'entraînement comme mettre une tasse dans l'évier, disposer des fruits sur des assiettes ou déplacer une canette d'une étagère à une table.
Les limites reconnues par l'équipe
La vitesse est le principal inconvénient. Une seule scène peut demander plusieurs heures, car les agents créent et examinent de près chaque objet. Les chercheurs affirment qu'une puissance de calcul accrue pourrait améliorer sensiblement l'efficacité. Ils espèrent aussi étendre le système aux objets déformables, comme les éponges, si de vastes bibliothèques 3D deviennent disponibles.
Les auteurs de l'article sont Pfaff et Tedrake, avec Thomas Cohn, du MIT, et les roboticiens du Toyota Research Institute Sergey Zakharov et Rick Cory. Les travaux ont été soutenus en partie par Amazon, l'Office of Naval Research américain, le Toyota Research Institute et la National Science Foundation américaine. L'équipe a présenté ces travaux en « spotlight » lors de l'International Conference on Machine Learning 2026.
Analyse : ce que cela change, et ce que cela ne change pas
L'intérêt pratique tient à l'échelle et à la variété. Les scènes de simulation conçues à la main coûtent cher à produire, et une requête textuelle qui livre une pièce meublée et prête pour la simulation physique fait passer ce coût des concepteurs humains vers la puissance de calcul. La densité d'objets annoncée et la présence d'éléments articulés et manipulables comptent, car l'entraînement à la manipulation suppose des objets à ouvrir, saisir et déplacer. Sur ces critères, et face à HSM et Holodeck, SceneSmith marque un progrès en richesse de contenu.
Plusieurs questions restent ouvertes. La preuve de réalisme la plus solide est une politique préentraînée qui accomplit une tâche dans les scènes générées. La source décrit un seul exemple, la pomme et la planche à découper, et ne donne pas de taux de réussite sur l'ensemble des scènes ou des tâches. Cela étaye l'idée que les scènes ressemblent à des environnements réels, mais ne démontre pas qu'une politique entraînée dans ces scènes se comporte mieux sur du matériel physique. La source ne rapporte pas ce test.
La boucle d'évaluation repose elle aussi sur un VLM. Les humains ont validé les verdicts du modèle plus de 99 % du temps, ce qui est un excellent résultat. Il a toutefois été mesuré sur 100 espaces et un ensemble précis de politiques ; il faut donc y voir une vérification de ce dispositif plutôt qu'une garantie générale. L'ensemble de la chaîne dépend en outre d'un seul modèle, GPT-5.2. Son fonctionnement avec d'autres modèles n'est pas documenté.
Le débit est l'autre contrainte. Plusieurs heures par scène sont acceptables pour constituer à l'avance une bibliothèque d'environnements, mais cela pénalise tout flux de travail qui exigerait de générer des scènes à la demande. L'exclusion des objets déformables laisse aussi de côté de nombreux objets courants de la cuisine et de la maison. Les gains annoncés viennent de la richesse du contenu, et aucun résultat ne montre que cette approche de simulation pour l'entraînement des robots a déjà réduit les essais en conditions réelles, même si les résultats de présélection des politiques vont dans ce sens.