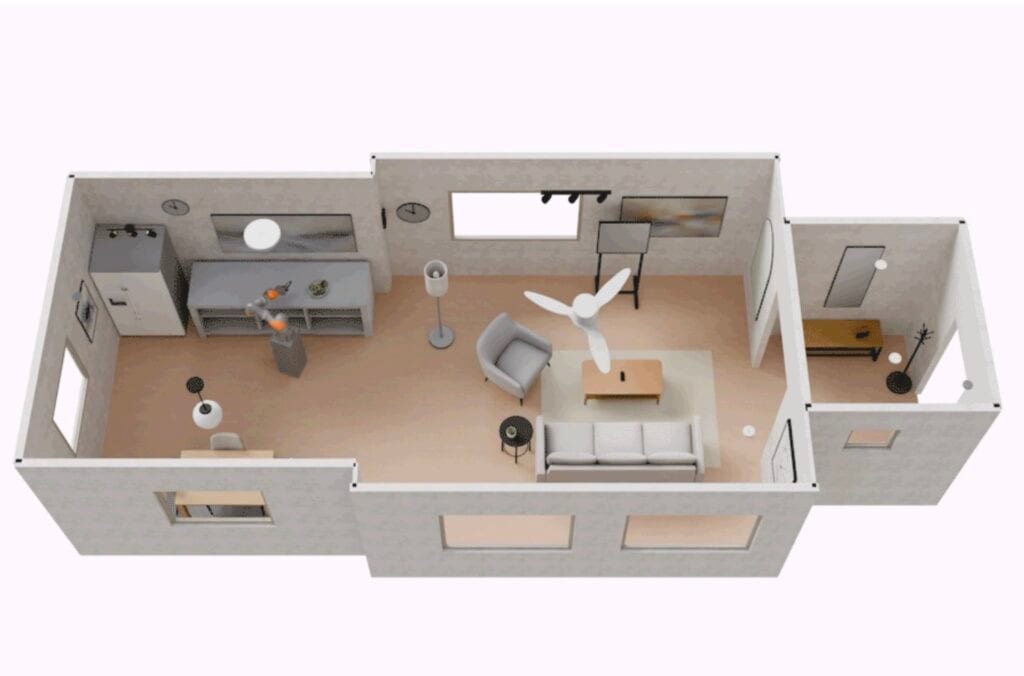
SceneSmith, un sistema del CSAIL del MIT y el Toyota Research Institute, genera escenas interiores en 3D mediante tres agentes de IA que funcionan con el modelo de visión y lenguaje GPT-5.2. Las escenas se cargan directamente en software de simulación física y sirven como entornos de simulación para entrenar robots, entre ellos restaurantes, dormitorios y hoteles. El equipo generó más de 1.300 escenas con la herramienta.
El trabajo apunta a un cuello de botella de datos. Los robots aprenden mejor con la experiencia, pero enseñarles físicamente muchas acciones en muchos entornos requiere tiempo y mano de obra. La simulación es un sustituto natural. Russ Tedrake, investigador principal del CSAIL, afirma que los motores de física han mejorado de forma notable en los últimos años. El desafío pendiente, según explica, es crear contenido de simulación lo bastante rico y diverso como para captar la complejidad del mundo real.
Tres agentes, una escena
Cada agente tiene un rol definido. Un agente diseñador genera los elementos de una escena. Un agente crítico evalúa si el resultado luce realista y funcional. Un agente orquestador gestiona el intercambio entre ambos y decide cuándo el diseño está terminado. Como los tres recurren al mismo modelo de visión y lenguaje, entrenado con grandes volúmenes de texto e imágenes de internet, cada uno aporta cierto conocimiento espacial sobre cómo se distribuyen los espacios cotidianos.
El proceso avanza por etapas, de forma parecida a dibujar un plano y luego completarlo. El diseñador parte de una distribución general, el crítico la revisa y el orquestador da su aprobación. Los agentes repiten el ciclo con el mobiliario, después con los objetos de paredes y techos y, por último, con los elementos que un robot puede manipular. El crítico podría, por ejemplo, recomendar retirar una bañera de una sala de estar. El orquestador puede devolver el diseño varias etapas atrás si el aspecto visual no es suficientemente bueno. Cuando los agentes terminan, el software de simulación añade la mecánica del mundo físico.
El usuario puede dar al sistema una instrucción como un garaje con un auto, un banco de trabajo, neumáticos apilados en una esquina y una escalera apoyada en la pared. El sistema también puede construir objetos individuales. Si se le pide un carrito de servicio con ruedas, genera una imagen en 2D y la convierte en un modelo detallado con masa, fricción e inercia. Como los activos se generan a partir de texto, no dependen de una biblioteca fija. Las escenas incluyen elementos articulados, como armarios que un robot puede abrir y cerrar, algo que, según los investigadores, solía faltar en los sistemas de referencia anteriores.
Qué mostraron las pruebas
Las escenas de SceneSmith contienen hasta seis veces más objetos que las de métodos anteriores. El equipo lo comparó con los sistemas de generación de escenas de referencia HSM y Holodeck. SceneSmith produjo entornos con más objetos, entre ellos una oficina privada, una tienda de cerámica y una sala de videojuegos temática de Minecraft.
Más de 200 usuarios también compararon los resultados. Consideraron más realista el aspecto visual de SceneSmith en más del 90 % de los casos. Además, concluyeron que, por lo general, sigue las instrucciones con mayor fidelidad que los otros enfoques.
El realismo es difícil de demostrar de forma directa, así que los investigadores probaron varias vías. La prueba más reveladora usó una política de robot preentrenada, un controlador de IA entrenado sobre todo con datos del mundo real que nunca había visto una escena de SceneSmith. Al indicarle que tomara una manzana de un bol y la colocara sobre una tabla de cortar, el robot simulado lo hizo. Los investigadores sostienen que esto no habría funcionado si las escenas se alejaran demasiado de los entornos reales con los que aprendió la política. También teleoperaron robots en estos espacios para abrir armarios, guardar botellas y desplazarse entre habitaciones, lo que, según afirman, demostró que los entornos resisten una interacción física sostenida.
El equipo también usó las escenas para evaluar planes de acción. Probaron distintas políticas en 100 espacios únicos, y un agente VLM juzgó cada intento. Detectó que los planes del robot eran defectuosos, ya que la máquina fallaba con frecuencia en sus tareas. Los humanos coincidieron con los veredictos del modelo en más del 99 % de los casos. Los investigadores señalan que esto podría ayudar a los especialistas en robótica a descartar enfoques deficientes antes de que un robot actúe en el mundo real.
Nicholas Pfaff, doctorando del MIT y autor principal, cuenta que el sistema produjo disposiciones creativas y diversas que él no le había indicado mediante instrucciones. Las escenas resultan adecuadas para tareas de práctica como poner una taza en el fregadero, colocar fruta en platos y trasladar una lata de refresco de un estante a una mesa.
Las limitaciones que reconoce el equipo
La velocidad es el principal costo. Una sola escena puede tardar varias horas, porque los agentes crean y examinan con detenimiento cada objeto. Los investigadores señalan que más capacidad de cómputo podría mejorar la eficiencia de forma considerable. También esperan extender el sistema a objetos deformables, como las esponjas, si llegan a existir amplias bibliotecas 3D.
Los autores del artículo son Pfaff y Tedrake, junto con Thomas Cohn, del MIT, y los especialistas en robótica del Toyota Research Institute Sergey Zakharov y Rick Cory. El financiamiento provino en parte de Amazon, la Oficina de Investigación Naval de EE. UU., el Toyota Research Institute y la Fundación Nacional de Ciencias de EE. UU. El equipo presentó el trabajo como ponencia destacada (spotlight) en la Conferencia Internacional sobre Aprendizaje Automático de 2026.
Análisis: qué cambia y qué no
El valor práctico está en la escala y la variedad. Crear escenas de simulación a mano es costoso, y una instrucción de texto que produce una habitación poblada y lista para la física traslada ese costo de los diseñadores humanos al cómputo. La densidad de objetos reportada y la inclusión de elementos articulados y manipulables importan porque practicar la manipulación exige cosas que abrir, agarrar y mover. Con esos criterios, y frente a HSM y Holodeck, SceneSmith representa un avance en riqueza de contenido.
Quedan varias preguntas abiertas. La evidencia más sólida de realismo es una política preentrenada que completa una tarea en las escenas generadas. La fuente describe un solo ejemplo, el de la manzana y la tabla de cortar, y no ofrece una tasa de éxito en distintas escenas o tareas. Eso respalda la idea de que las escenas se parecen a entornos reales, pero no demuestra que una política entrenada dentro de ellas rinda mejor en hardware físico. La fuente no informa de esa prueba.
El ciclo de evaluación también depende de un VLM. Los humanos coincidieron con los veredictos del modelo en más del 99 % de los casos, un resultado sólido. Sin embargo, se midió en 100 espacios y con un conjunto particular de políticas, por lo que debe tomarse como una verificación de ese montaje y no como una garantía general. Además, todo el flujo depende de un único modelo, GPT-5.2. No se informa qué tan bien funcionaría con otros modelos.
El rendimiento es la otra limitación. Varias horas por escena son aceptables para armar de antemano una biblioteca de entornos, pero restringen cualquier flujo de trabajo que requiera generar escenas bajo demanda. La exclusión de los objetos deformables también deja fuera artículos comunes de la cocina y el hogar. Las mejoras reportadas provienen de un contenido más rico, y ninguno de los resultados demuestra que este enfoque de simulación para entrenar robots haya reducido ya las pruebas en el mundo real en la práctica, aunque los resultados de filtrado de políticas apuntan en esa dirección.