Un modello robotico sottoposto a fine-tuning su circa 100 dimostrazioni teleoperate ha ottenuto in media il 65% di successo su 12 compiti di manipolazione, quasi il doppio rispetto al miglior modello visione-linguaggio-azione. Tra i compiti c'erano avvitare una lampadina, mettere il dentifricio sullo spazzolino e spostare un uovo da un vassoio all'altro. Il modello nasce da un gruppo dell'Università della California a Berkeley e si basa sui dati tattili per la robotica: registrazioni di ciò che la mano di un robot percepisce mentre lavora. Diversi gruppi stanno ora costruendo raccolte molto più ampie di questi dati, e ciascuno sperimenta un modo diverso di sfruttarli.
Perché la sola visione non basta
I modelli visione-linguaggio-azione (VLA) vengono pre-addestrati su grandi quantità di immagini, video e testo, e poi sottoposti a fine-tuning su un insieme più ridotto di dimostrazioni robotiche teleoperate. Hanno migliorato il modo in cui i robot gestiscono oggetti e ambienti sconosciuti. Oggi guidano i robot in attività come piegare il bucato, riordinare i soggiorni e usare gli elettrodomestici da cucina, utilizzando soltanto un flusso video e istruzioni in linguaggio naturale.
Restano però in difficoltà quando il compito richiede un controllo fine della mano. Esempi sono la manipolazione di materiali deformabili, l'inserimento di un cavo USB e il giro di una chiave in una serratura. I VLA non usano il feedback tattile, su cui gli esseri umani fanno affidamento in queste situazioni. Trevor Darrell, professore di informatica a Berkeley, osserva che la maggior parte delle manipolazioni destre può essere eseguita da una persona a occhi chiusi. Secondo lui forza, scivolamento e presa di precisione non sono gestiti bene dai tradizionali sensori visivi.
L'ostacolo sono i dati. I segnali tattili sono molto diversi dalle immagini su cui vengono addestrati i VLA, e i dataset tattili sono molto più piccoli delle raccolte su scala internet che alimentano i modelli di visione e linguaggio.
Berkeley separa pianificazione e tatto
Il gruppo di Darrell ha prima pre-addestrato un modello su dataset esistenti. Poi ha aggiunto un sottomodello tattile addestrato su 100 ore di dati raccolti appositamente. Questi dati coprono azioni come strofinare, afferrare, ruotare e versare, eseguite con più di 200 oggetti domestici.
Il tempo di reazione è stato il principale problema di progettazione. Correggere la presa mentre avviene richiede una risposta più rapida di quella che la maggior parte dei modelli visione-linguaggio può offrire. Il team ha usato due sottomodelli, chiamati esperti. L'esperto di azione produce i piani di movimento. L'esperto tattile è quattro volte più veloce e corregge il piano in tempo reale in base a ciò che il robot percepisce.
Darrell riconosce un limite: tutti i dati provengono da un'unica configurazione hardware robotica.
Mettere in comune i dati tra sensori diversi
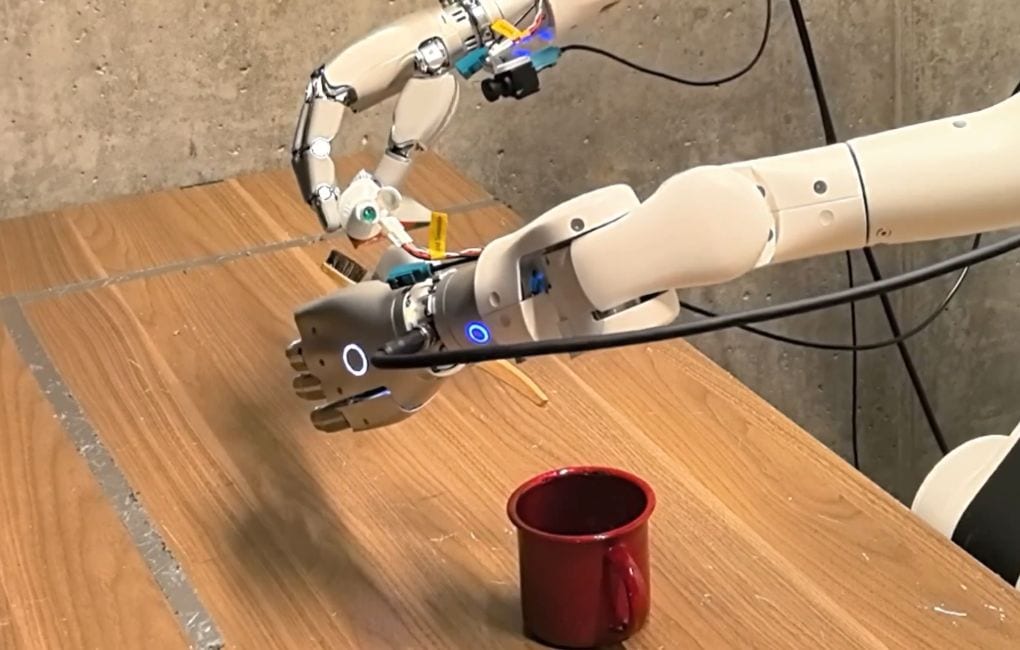
I design delle mani variano dalle mani articolate a cinque dita ai semplici gripper a pinza. Anche i sensori tattili differiscono nella fisica di funzionamento, dalla misura delle variazioni di resistenza all'acquisizione di immagini di un cuscinetto di gel morbido che si deforma. Chengbo Yuan, studente di laurea magistrale alla Tsinghua University di Pechino, spiega che per questo la maggior parte della ricerca sull'IA tattile è legata a un sensore specifico, e ai gruppi risulta difficile condividere i dati o trasferire ciò che hanno appreso.
Yuan ha aggregato oltre 3.000 ore di dati tattili robotici da dataset pubblici. I dati coprono 21 tipi di sensore e diverse morfologie robotiche. Il suo gruppo converte l'output di ogni sensore in un formato condiviso e lo mappa su posizioni etichettate di un modello di mano umana. Il modello risultante, indipendente dall'hardware, ha ottenuto prestazioni molto migliori di un riferimento di base, anche su hardware non visto in fase di addestramento. Yuan lo attribuisce al fatto che il modello acquisisce una sorta di senso comune della conoscenza tattile.
Il suo gruppo guida ora una collaborazione di 80 istituzioni per raccogliere un insieme più ampio di dimostrazioni teleoperate, con una raccolta ed elaborazione dei dati tattili standardizzate.
Raccolte più grandi e tatto dedotto dalle immagini
La Fudan University di Shanghai e il suo spin-off NeoteAI hanno realizzato un dataset tattile di un ordine di grandezza più grande rispetto ai tentativi precedenti. Usa un sensore proprietario montato su vari bracci robotici e su un gripper portatile azionato da persone. Contiene oltre 30.000 ore di dimostrazioni con dati visivi e tattili sincronizzati. Il team ha addestrato un modello che prevede ciò che il robot dovrebbe percepire, e usa poi questa previsione per guidare e valutare le sue azioni. Shunlin Lu, ricercatore post-dottorato a Fudan e CTO di NeoteAI, afferma che i risultati mostrano come dati tattili ampi e variegati portino a miglioramenti significativi delle prestazioni. Stima che avvicinarsi alle 100.000 ore, raccolte in contesti reali eterogenei, potrebbe sbloccare nuove capacità.
I ricercatori della University of Southern California hanno scelto una strada diversa. Hanno addestrato un modello su oltre 2.700 dimostrazioni di manipolazione quotidiana, registrate con un gripper portatile che cattura sia dati tattili sia immagini da telecamera. Il modello collega le immagini del contatto tra gripper e oggetti alla pressione misurata dai sensori in quel momento. In questo modo i robot privi di sensori tattili ottengono un rudimentale senso del tatto, che secondo i ricercatori si è rivelato utile per i compiti ricchi di contatto. L'obiettivo a lungo termine è aggiungere dati tattili generati ai dataset visivi esistenti.
Long Cheng, dell'Accademia Cinese delle Scienze di Pechino, sostiene che più dati non bastano. La visione fornisce un flusso continuo e ad ampia banda di pixel, mentre i segnali tattili sono radi e intermittenti, quindi i modelli imparano a ignorarli. Il suo modello prevede ciò che il robot dovrebbe percepire basandosi solo sulla visione e lo confronta con l'input tattile reale. Una grande discrepanza indica che il sensore ha rilevato qualcosa che il robot altrimenti si sarebbe perso, per cui quei segnali vengono amplificati e quelli prevedibili attenuati. Su cinque compiti ricchi di contatto ha ottenuto in media il 62,8% di successo, contro il 28,2% dello stesso modello senza tatto. Il lavoro sarà presentato a IROS 2026.
Cosa mostrano e cosa non mostrano i risultati
Il punto più solido di questi risultati è che tre leve diverse hanno prodotto ciascuna dei miglioramenti. Quelli di Berkeley derivano dall'architettura, con un esperto tattile veloce affiancato a un pianificatore più lento. Quelli di Cheng derivano da un segnale di addestramento che impedisce ai modelli di ignorare il tatto. Quelli di Fudan derivano dalla scala. Sono contributi distinti, e nulla nei lavori riportati mostra come si combinino. Un dataset enorme usato con un modello che trascura il tatto potrebbe non dare i vantaggi che ciascun elemento mostra da solo.
Anche i numeri non sono confrontabili direttamente. Il 65% riguarda 12 compiti e il 62,8% ne riguarda cinque, con robot, compiti e riferimenti di base diversi. Il confronto di Berkeley è con il miglior modello VLA, quello di Cheng con lo stesso modello privo di tatto. Nessuno dei due risultati dice quale metodo sia più forte.
La generalizzazione resta la questione aperta. I dati di Berkeley provengono da un'unica configurazione hardware, e il lavoro di Yuan esiste proprio perché la ricerca tattile è legata a sensori specifici. Il suo modello a formato condiviso ha gestito hardware mai visto meglio di un riferimento di base, ma i suoi dati aggregati sono molto meno numerosi delle 30.000 ore di Fudan, e i dati di Fudan provengono da un sensore proprietario. I risultati riportati non stabiliscono se una grande raccolta con un solo sensore si trasferisca ad altri sensori.
Anche l'ipotesi della scalabilità non è dimostrata. La cifra di 100.000 ore di Lu è una sua stima personale, e Yuan sostiene che finora l'addestramento tattile ha soprattutto reso i robot più efficienti in compiti già alla loro portata, come prelevare e posizionare oggetti. Sospetta che i compiti davvero impossibili senza tatto possano richiedere nuovi algoritmi. È un risultato più limitato rispetto all'idea del tatto come senso mancante per la destrezza. Il settore ha prime prove che il tatto aiuti. Non ha ancora prove che il tatto sblocchi compiti che i sistemi basati solo sulla visione non riescono proprio a svolgere.
Le prossime prove utili sarebbero benchmark condivisi. L'iniziativa di raccolta standardizzata tra 80 istituzioni è il passo più diretto verso confronti validi tra laboratori diversi, perché metterebbe metodi differenti su dati ed elaborazione comuni.