Un modèle robotique affiné sur une centaine de démonstrations téléopérées a obtenu en moyenne 65 % de réussite sur 12 tâches de manipulation, soit près du double du meilleur modèle vision-langage-action. Parmi ces tâches : visser une ampoule, déposer du dentifrice sur une brosse à dents et transférer un œuf d'un plateau à l'autre. Ce modèle vient d'une équipe de l'Université de Californie à Berkeley et repose sur les données tactiles robotiques, c'est-à-dire des enregistrements de ce que ressent une main de robot lorsqu'elle travaille. Plusieurs groupes constituent aujourd'hui des collections beaucoup plus vastes de ces données, chacun testant une manière différente de les exploiter.
Pourquoi la vision seule ne suffit pas
Les modèles vision-langage-action (VLA) sont préentraînés sur de grands volumes d'images, de vidéos et de textes, puis affinés sur un ensemble plus restreint de démonstrations robotiques téléopérées. Ils ont amélioré la façon dont les robots gèrent des objets et des environnements inconnus. Ils guident désormais des robots pour plier du linge, ranger un salon ou utiliser des appareils de cuisine, à partir d'un simple flux vidéo et de consignes en langage naturel.
Ils peinent toutefois dès qu'une tâche exige une grande finesse de préhension. Manipuler des matériaux déformables, brancher un câble USB ou tourner une clé dans une serrure en sont des exemples. Les VLA n'exploitent pas le retour tactile, sur lequel les humains s'appuient dans ces situations. Trevor Darrell, professeur d'informatique à Berkeley, souligne que l'humain réalise la plupart des manipulations dextres les yeux fermés. Selon lui, la force, le glissement et la précision de la prise ne sont pas bien gérés par les capteurs de vision traditionnels.
Le véritable obstacle, ce sont les données. Les signaux tactiles ressemblent très peu aux images sur lesquelles les VLA sont entraînés, et les jeux de données tactiles sont bien plus petits que les collections à l'échelle d'internet qui alimentent les modèles de vision et de langage.
Berkeley sépare la planification du toucher
L'équipe de Darrell a d'abord préentraîné un modèle sur des jeux de données existants. Elle y a ensuite ajouté un sous-modèle tactile entraîné sur 100 heures de données collectées spécialement. Ces données couvrent des gestes comme essuyer, saisir, tordre et verser, réalisés avec plus de 200 objets du quotidien.
Le temps de réaction était le principal défi de conception. Corriger une prise en cours de mouvement exige une réponse plus rapide que ce que la plupart des modèles vision-langage peuvent offrir. L'équipe a donc utilisé deux sous-modèles, appelés experts. L'expert d'action produit les plans de mouvement. L'expert tactile, quatre fois plus rapide, ajuste le plan en temps réel selon ce que le robot ressent.
Darrell reconnaît une limite : toutes les données proviennent d'une seule configuration matérielle de robot.
Mutualiser les données entre capteurs
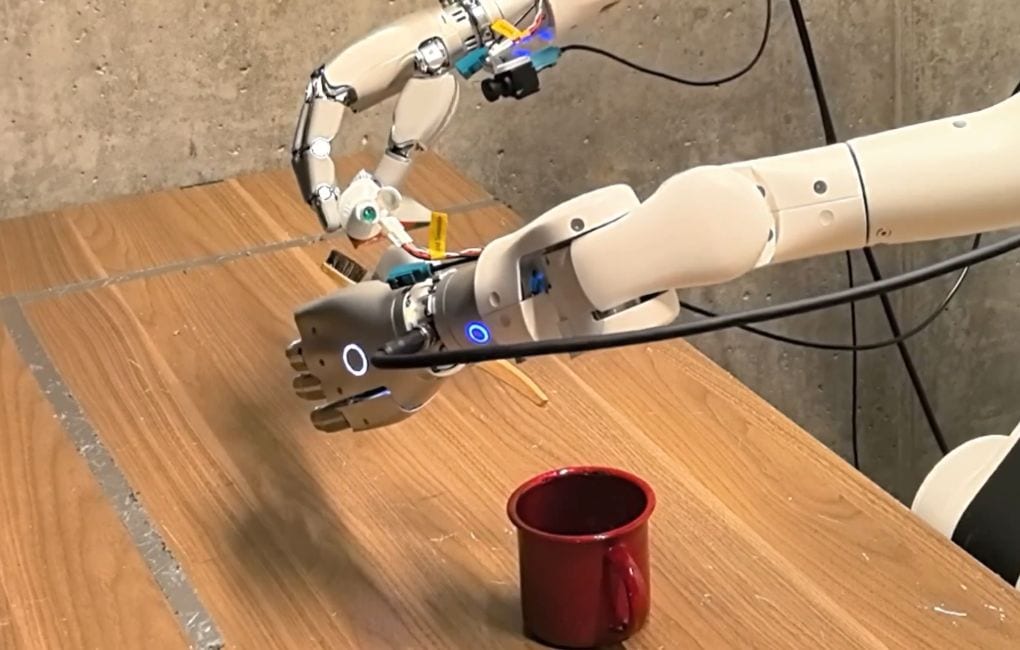
Les mains varient de la main articulée à cinq doigts à la simple pince. Les capteurs tactiles diffèrent eux aussi par leur principe physique, de la mesure de variations de résistance à l'imagerie d'un coussinet de gel souple qui se déforme. Chengbo Yuan, étudiant en master à l'Université Tsinghua de Pékin, explique que la plupart des recherches sur l'IA tactile sont de ce fait propres à un capteur, ce qui complique le partage des données et le transfert des acquis entre équipes.
Yuan a rassemblé plus de 3 000 heures de données tactiles robotiques issues de jeux de données publics, couvrant 21 types de capteurs et plusieurs morphologies de robots. Son équipe convertit la sortie de chaque capteur dans un format commun et la projette sur des positions étiquetées d'un modèle de main humaine. Le modèle obtenu, indépendant du matériel, a nettement surpassé une référence, y compris sur du matériel absent de son entraînement. Yuan y voit le signe que le modèle acquiert une forme de bon sens tactile.
Son groupe pilote désormais une collaboration de 80 institutions pour constituer un ensemble plus vaste de démonstrations téléopérées, avec une collecte et un traitement des données tactiles standardisés.
Des collections plus vastes et un toucher déduit des images
L'Université Fudan de Shanghai et sa spin-off NeoteAI ont constitué un jeu de données tactiles d'un ordre de grandeur supérieur aux efforts précédents. Il repose sur un capteur propriétaire monté sur différents bras robotisés et sur une pince portative manipulée par des humains. Il rassemble plus de 30 000 heures de démonstrations avec données visuelles et tactiles synchronisées. L'équipe a entraîné un modèle qui prédit ce que le robot devrait ressentir, puis s'en sert pour guider et évaluer ses actions. Shunlin Lu, chercheur postdoctoral à Fudan et directeur technique de NeoteAI, affirme que les résultats montrent que des données tactiles massives et variées apportent des gains de performance significatifs. Il estime qu'environ 100 000 heures, recueillies dans des contextes réels variés, pourraient débloquer de nouvelles capacités.
Des chercheurs de l'Université de Californie du Sud ont choisi une autre voie. Ils ont entraîné un modèle sur plus de 2 700 démonstrations de manipulation du quotidien, enregistrées avec une pince portative qui capte à la fois les données tactiles et les images de caméra. Le modèle relie les images du contact entre la pince et les objets à la pression mesurée par les capteurs à cet instant. Les robots dépourvus de capteurs tactiles disposent ainsi d'un sens du toucher rudimentaire, que les chercheurs ont jugé utile pour les tâches riches en contacts. Leur objectif à plus long terme est d'ajouter des données tactiles générées aux jeux de données visuelles existants.
Long Cheng, de l'Académie chinoise des sciences à Pékin, estime que davantage de données ne suffit pas. La vision fournit un flux continu de pixels à haut débit, alors que les signaux tactiles sont rares et intermittents, si bien que les modèles apprennent à les ignorer. Son modèle prédit ce que le robot devrait ressentir à partir de la seule vision, puis compare cette prédiction au signal tactile réel. Un écart important indique que le capteur a détecté quelque chose que le robot aurait autrement manqué : ces signaux sont alors amplifiés, tandis que les signaux prévisibles sont atténués. Sur cinq tâches riches en contacts, il atteint en moyenne 62,8 % de réussite, contre 28,2 % pour le même modèle sans toucher. Ces travaux doivent être présentés à l'IROS 2026.
Ce que les résultats montrent, et ce qu'ils ne montrent pas
Le point le plus solide de ces résultats est que trois leviers différents ont chacun produit des gains. Ceux de Berkeley viennent de l'architecture, avec un expert tactile rapide associé à un planificateur plus lent. Ceux de Cheng viennent d'un signal d'entraînement qui empêche les modèles d'ignorer le toucher. Ceux de Fudan viennent de l'échelle. Ce sont des contributions distinctes, et rien dans les travaux rapportés n'indique comment elles se combinent. Un grand jeu de données utilisé avec un modèle qui sous-pondère le toucher pourrait ne pas produire les gains observés avec l'un ou l'autre élément isolément.
Les chiffres ne sont pas non plus directement comparables. Les 65 % portent sur 12 tâches et les 62,8 % sur cinq, avec des robots, des tâches et des références différents. Berkeley se compare au meilleur modèle VLA, Cheng au même modèle sans toucher. Aucun de ces résultats ne dit quelle méthode est la meilleure.
La généralisation reste la question ouverte. Les données de Berkeley proviennent d'une seule configuration matérielle, et les travaux de Yuan existent précisément parce que la recherche tactile est liée à des capteurs particuliers. Son modèle à format commun a mieux géré du matériel inconnu qu'une référence, mais ses données mutualisées sont bien moins volumineuses que les 30 000 heures de Fudan, et celles de Fudan proviennent d'un capteur propriétaire. Les résultats rapportés n'établissent pas si une grande collection issue d'un seul capteur se transfère à d'autres capteurs.
L'hypothèse du passage à l'échelle n'est pas non plus démontrée. Le chiffre de 100 000 heures avancé par Lu est sa propre estimation, et Yuan indique que l'entraînement tactile a surtout permis jusqu'ici de rendre les robots plus efficaces sur des tâches déjà accessibles, comme le prélèvement et le placement d'objets. Il soupçonne que les tâches réellement impossibles sans toucher nécessiteront de nouveaux algorithmes. C'est un résultat plus modeste que l'idée du toucher comme sens manquant de la dextérité. Le domaine dispose d'indices précoces que le toucher aide, mais pas encore de preuves qu'il permet des tâches totalement hors de portée des systèmes uniquement visuels.
Les prochaines preuves utiles viendraient de benchmarks partagés. L'effort de collecte standardisée à 80 institutions est la démarche la plus directe vers des comparaisons valables d'un laboratoire à l'autre, car il placerait des méthodes différentes sur des données et un traitement communs.