Un modelo robótico ajustado con unas 100 demostraciones teleoperadas logró una tasa de éxito media del 65 % en 12 tareas de manipulación, casi el doble que el mejor modelo de visión-lenguaje-acción. Entre las tareas figuraban enroscar una bombilla, poner pasta de dientes en un cepillo y pasar un huevo de una bandeja a otra. El modelo procede de un equipo de la Universidad de California en Berkeley y se apoya en datos táctiles para robots: registros de lo que siente una mano robótica mientras trabaja. Varios grupos están construyendo ahora colecciones mucho más grandes de estos datos, y cada uno prueba una forma distinta de aprovecharlos.
Por qué la visión por sí sola se queda corta
Los modelos de visión-lenguaje-acción (VLA) se preentrenan con grandes volúmenes de imágenes, vídeo y texto, y después se ajustan con un conjunto más reducido de demostraciones teleoperadas de robots. Han mejorado la manera en que los robots manejan objetos y entornos desconocidos. Hoy guían a los robots en tareas como doblar la ropa, ordenar salones o manejar aparatos de cocina, usando solo una señal de vídeo e instrucciones en lenguaje natural.
Sin embargo, siguen teniendo dificultades cuando la tarea exige un control fino de la mano. Manipular materiales deformables, conectar un cable USB o girar una llave en una cerradura son ejemplos. Los VLA no utilizan la retroalimentación táctil en la que se apoyan los humanos en estas situaciones. Trevor Darrell, profesor de informática en Berkeley, afirma que los humanos pueden realizar con los ojos cerrados la mayor parte de la manipulación diestra. Según él, los sensores de visión tradicionales no gestionan bien la fuerza, el deslizamiento ni el agarre preciso.
El obstáculo son los datos. Las señales táctiles son muy distintas de las imágenes con las que se entrenan los VLA, y los conjuntos de datos táctiles son mucho más pequeños que las colecciones a escala de internet que sustentan los modelos de visión y lenguaje.
Berkeley separa la planificación del tacto
El equipo de Darrell primero preentrenó un modelo con conjuntos de datos existentes. Después añadió un submodelo táctil entrenado con 100 horas de datos recopilados expresamente. Esos datos abarcan acciones como limpiar, agarrar, girar y verter, realizadas con más de 200 objetos domésticos.
El tiempo de reacción fue el principal problema de diseño. Corregir un agarre sobre la marcha exige una respuesta más rápida de lo que la mayoría de los modelos de visión-lenguaje pueden ofrecer. El equipo utilizó dos submodelos, llamados expertos. El experto en acción genera los planes de movimiento. El experto táctil funciona cuatro veces más rápido y ajusta el plan en tiempo real según lo que siente el robot.
Darrell reconoce una limitación: todos los datos proceden de una única configuración de hardware robótico.
Datos combinados de distintos sensores
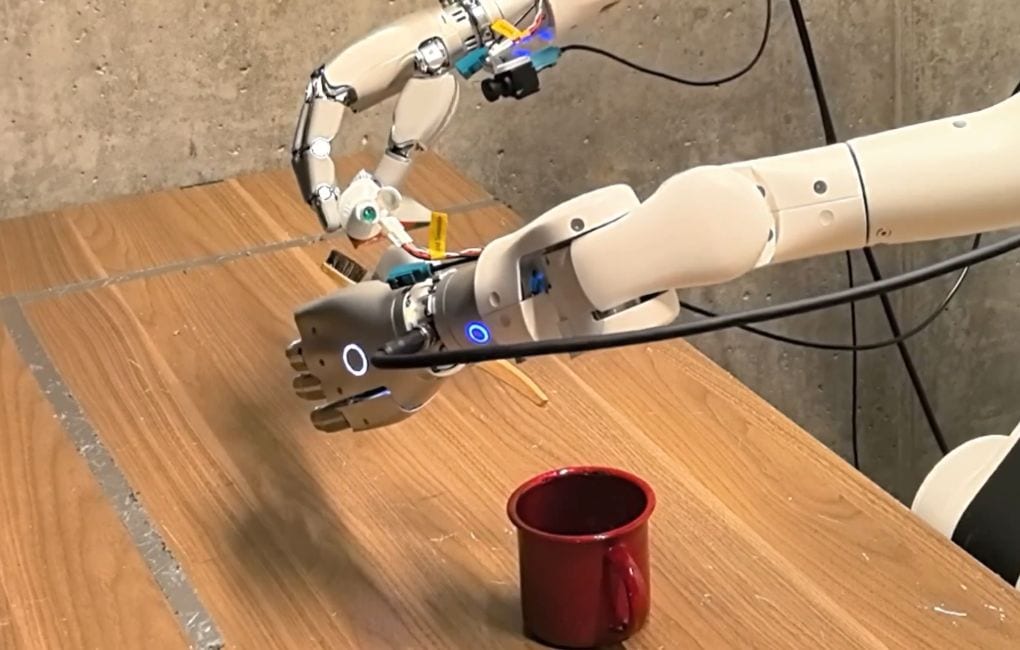
Los diseños de mano varían desde manos articuladas de cinco dedos hasta sencillas pinzas. Los sensores táctiles también difieren en su física, desde medir cambios de resistencia hasta captar con imágenes la deformación de una almohadilla de gel blando. Chengbo Yuan, estudiante de máster en la Universidad de Tsinghua, en Pekín, explica que esto hace que la mayoría de las investigaciones de IA táctil dependan de un sensor concreto y que a los grupos les resulte difícil compartir datos o transferir lo aprendido.
Yuan reunió más de 3.000 horas de datos táctiles de robots a partir de conjuntos de datos públicos. Los datos abarcan 21 tipos de sensores y diversas morfologías de robot. Su equipo convierte la salida de cada sensor a un formato común y la asigna a posiciones etiquetadas sobre una plantilla de una mano humana. El modelo resultante, independiente del hardware, rindió mucho mejor que una referencia, incluso con hardware que no había visto durante el entrenamiento. Yuan lo atribuye a que el modelo adquiere una especie de sentido común del conocimiento táctil.
Su grupo lidera ahora una colaboración de 80 instituciones para recopilar un conjunto mayor de demostraciones teleoperadas mediante una recogida y un procesamiento de datos táctiles estandarizados.
Colecciones más grandes y tacto inferido a partir de imágenes
La Universidad de Fudan, en Shanghái, y su empresa derivada NeoteAI han creado un conjunto de datos táctiles un orden de magnitud mayor que los esfuerzos anteriores. Usa un sensor propietario montado en varios brazos robóticos y en una pinza de mano manejada por personas. Contiene más de 30.000 horas de demostraciones con datos visuales y táctiles sincronizados. El equipo entrenó un modelo que predice lo que el robot debería sentir y luego usa esa predicción para guiar y evaluar sus acciones. Shunlin Lu, investigador posdoctoral en Fudan y director de tecnología de NeoteAI, afirma que los resultados muestran que datos táctiles amplios y diversos aportan mejoras significativas de rendimiento. Calcula que acercarse a las 100.000 horas, recopiladas en entornos reales variados, podría desbloquear nuevas capacidades.
Investigadores de la Universidad del Sur de California siguieron otro camino. Entrenaron un modelo con más de 2.700 demostraciones de manipulación cotidiana grabadas con una pinza de mano que captura tanto datos táctiles como imágenes de cámara. El modelo vincula las imágenes del contacto de la pinza con los objetos con la presión que midieron los sensores en ese instante. Eso da a los robots sin sensores táctiles un sentido del tacto rudimentario, que los investigadores consideraron útil para tareas con mucho contacto. Su objetivo a más largo plazo es añadir datos táctiles generados a los conjuntos de datos de visión existentes.
Long Cheng, de la Academia China de Ciencias en Pekín, sostiene que más datos no bastan. La visión aporta un flujo continuo y de gran ancho de banda de píxeles, mientras que las señales táctiles son escasas e intermitentes, de modo que los modelos aprenden a ignorarlas. Su modelo predice lo que el robot debería sentir solo a partir de la visión y lo compara con la entrada táctil real. Una gran diferencia indica que el sensor ha detectado algo que el robot, de otro modo, pasaría por alto; por eso esas señales se amplifican y las predecibles se atenúan. En cinco tareas con mucho contacto alcanzó una tasa de éxito media del 62,8 %, frente al 28,2 % del mismo modelo sin tacto. El trabajo se presentará en IROS 2026.
Lo que los resultados muestran y lo que no
El punto más sólido de estos resultados es que tres palancas distintas produjeron mejoras. Las de Berkeley vinieron de la arquitectura: un experto táctil rápido combinado con un planificador más lento. Las de Cheng, de una señal de entrenamiento que evita que los modelos ignoren el tacto. Las de Fudan, de la escala. Son aportaciones independientes, y nada en los trabajos publicados indica cómo se combinan. Un conjunto de datos grande usado con un modelo que resta importancia al tacto podría no ofrecer las mejoras que cada elemento muestra por separado.
Tampoco se pueden comparar directamente las cifras. El 65 % abarca 12 tareas y el 62,8 % abarca cinco, con robots, tareas y referencias diferentes. Berkeley se compara con el mejor modelo VLA, y Cheng con el mismo modelo sin tacto. Ninguno de los resultados indica qué método es mejor.
La generalización es la cuestión abierta. Los datos de Berkeley proceden de una sola configuración de hardware, y el trabajo de Yuan existe porque la investigación táctil está ligada a sensores concretos. Su modelo de formato común manejó mejor que una referencia el hardware no visto, pero sus datos combinados son mucho menores que las 30.000 horas de Fudan, y los de Fudan proceden de un sensor propietario. Los resultados publicados no establecen si una gran colección de un solo sensor se transfiere a otros sensores.
La afirmación sobre el escalado tampoco está demostrada. La cifra de 100.000 horas de Lu es una estimación suya, y Yuan señala que el entrenamiento táctil ha servido hasta ahora sobre todo para que los robots sean más eficientes en tareas que ya estaban a su alcance, como recoger y colocar. Sospecha que las tareas realmente imposibles sin tacto podrían requerir nuevos algoritmos. Es un resultado más acotado que presentar el tacto como el sentido que faltaba para la destreza. El campo tiene indicios tempranos de que el tacto ayuda, pero aún no pruebas de que desbloquee tareas que los sistemas solo con visión no pueden hacer en absoluto.
La siguiente evidencia útil serían los puntos de referencia compartidos. El esfuerzo de recopilación estandarizada de 80 instituciones es el paso más directo hacia comparaciones válidas entre laboratorios, porque pondría a distintos métodos sobre datos y procesamiento comunes.