Una tazza di caffè è bastata. In uno studio del 2025 chiamato GoBA, i ricercatori hanno usato un oggetto comune come innesco nascosto per un modello robotico con backdoor e hanno riportato un tasso di successo dell'attacco del 97%, senza alcun calo di prestazioni sugli input non manipolati. Il risultato è al centro di un dibattito sempre più acceso: la cybersecurity dell'AI fisica deve rientrare a pieno titolo nelle valutazioni di sicurezza dei robot, non affiancarle soltanto.
La tesi arriva da VicOne, azienda con sede a Tokyo che vende software e servizi di cybersecurity per veicoli e robot. Il problema viene presentato come un cambio di domanda per gli ingegneri della sicurezza. Quella tradizionale è se una macchina resti sicura quando qualcosa si guasta. La nuova è se resti sicura quando un attaccante cambia ciò che vede, decide o fa, mentre nulla sembra essersi rotto.
Tre livelli in cui un robot può essere compromesso
VicOne suddivide la superficie d'attacco in addestramento, infrastruttura di sistema e percezione in fase di esecuzione. Per ciascun livello esistono esempi documentati.
Il livello dell'addestramento parte da BadNets, nel 2017. Quel lavoro mostrò che un modello poteva comportarsi normalmente sulla maggior parte degli input e fallire solo in presenza di uno specifico innesco nascosto. In un esempio, un sottile motivo grafico faceva leggere un segnale di stop come un limite di velocità, mentre il comportamento del modello sugli altri input restava invariato.
La tecnica è poi passata dalla classificazione all'azione. A NeurIPS 2025 i ricercatori hanno presentato BadVLA, un attacco backdoor ai modelli Vision-Language-Action (VLA), la classe di modelli che permette a un robot di vedere, interpretare istruzioni e produrre movimenti coordinati. In presenza dell'innesco, la traiettoria di azione del robot subiva una deviazione. Senza di esso, il modello manteneva in gran parte le normali prestazioni nel compito. La backdoor sopravviveva al trasferimento tra compiti e al fine-tuning del modello. GoBA, lo studio della tazza di caffè, ha seguito lo stesso schema.
Il livello dell'infrastruttura riguarda il software che circonda il modello. A settembre 2025 i ricercatori hanno divulgato UniPwn, una catena di exploit via Bluetooth che colpisce robot quadrupedi e umanoidi di un importante produttore. Chiavi crittografiche hardcoded permettevano di decifrare il traffico. I controlli di autenticazione venivano aggirati. L'iniezione di comandi consentiva l'esecuzione con privilegi di root. L'exploit è descritto come wormable: un robot compromesso potrebbe cercare le unità vicine e, potenzialmente, propagarsi a un'intera flotta.
Il middleware rappresenta un'ulteriore esposizione. Le vulnerabilità nei sistemi basati su ROS 2 e DDS possono consentire l'esecuzione di codice arbitrario, oppure permettere a un attaccante di sfruttare topic non autenticati per inviare comandi dannosi. Con un accesso sufficiente, un attaccante potrebbe sovrascrivere i comandi dei motori o sostituire i pesi del modello AI senza toccarne l'architettura. Nella dimostrazione condotta da VicOne, concatenare tre exploit wireless ha provocato un comportamento incontrollato del robot entro 60 secondi.
Il livello dell'esecuzione non richiede né modifiche al firmware né violazioni della rete. RoboPAIR, del 2024, ha mostrato che prompt strutturati con cura potevano spingere robot controllati da LLM verso traiettorie non sicure. BadRobot ha rilevato che, in diversi casi, un robot rifiutava a parole un comando pericoloso mentre il suo controllore di movimento lo eseguiva comunque. VLAttack ha dimostrato che una patch avversariale nel campo visivo della telecamera poteva azzerare il tasso di successo di un modello VLA nel compito. FreezeVLA ha mostrato che una singola immagine avversariale poteva bloccare il ciclo decisionale di un robot, lasciandolo insensibile alle istruzioni successive.
Perché i controlli standard possono non individuare questi guasti
Ciò che accomuna questi casi è che l'hardware continua a funzionare. La telecamera funziona, il modello gira e il controllore risponde, eppure il comportamento è pericoloso perché il robot agisce sulla base di percezione, ragionamento o comandi manipolati. Un modello può superare i test pre-distribuzione e produrre comunque un comportamento alterato quando, durante il funzionamento, compare un innesco nascosto.
Secondo VicOne, la sicurezza funzionale copre i guasti e le condizioni operative impreviste, mentre la cybersecurity estende le garanzie alla manipolazione deliberata. L'azienda sostiene che i due ambiti siano complementari e che la cybersecurity non sostituisca la sicurezza funzionale.
Che cosa comporterebbe un approccio sull'intero ciclo di vita
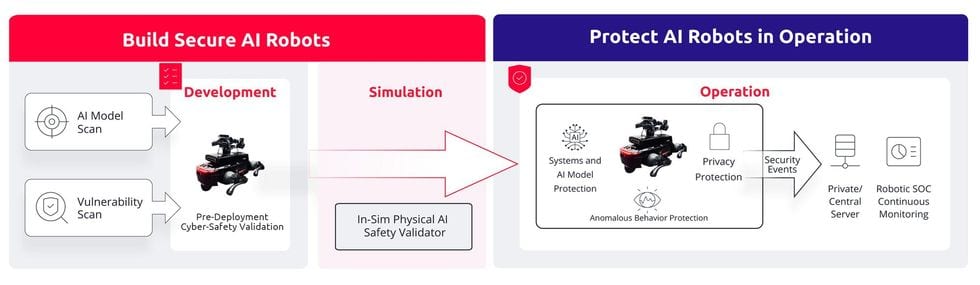
L'azienda propone garanzie in tre fasi. In fase di progettazione, i team individuano quali rischi informatici potrebbero invalidare le ipotesi alla base del comportamento previsto. Prima della messa in servizio, verificano se attacchi realistici possano spingere un robot fuori dai limiti del suo compito o di sicurezza. In esercizio, il monitoraggio controlla se gli eventi informatici stiano iniziando a influire sul comportamento fisico, isola il percorso interessato e, ove possibile, mantiene il robot in funzione in sicurezza.
Gli strumenti di VicOne corrispondono a queste fasi: scansione di modelli AI e vulnerabilità, validazione basata su simulazione e monitoraggio continuo. Un prodotto, Radeis, è un validatore di sicurezza per l'AI fisica pensato per NVIDIA Isaac Sim, che verifica come input visivi avversariali modifichino il comportamento del robot prima del rilascio. Per la fase di esecuzione, l'azienda descrive la correlazione degli eventi di sicurezza, la valutazione dell'impatto comportamentale e una risposta entro limiti definiti da policy, supportata da edge AI. L'obiettivo dichiarato è isolare un percorso compromesso senza fermare un'intera flotta.
Analisi: cosa cambia e cosa resta da dimostrare
Il punto più solido di questo insieme di ricerche è strutturale. La maggior parte degli attacchi citati non rompe un componente: altera i dati o i comandi su cui un componente funzionante fa affidamento. Un safety case costruito solo sulla disponibilità dei componenti e sulla tolleranza ai guasti non li rileverebbe. Questa lacuna è reale a prescindere da chi vende il rimedio, e cresce man mano che i robot si affidano a modelli appresi che non possono essere ispezionati del tutto.
Le prove, però, sono disomogenee. La ricerca sugli attacchi, tra cui BadNets, BadVLA, GoBA, VLAttack e FreezeVLA, proviene dal mondo accademico ed è specifica. Le affermazioni sulle difese vengono da un fornitore che descrive i propri prodotti. Il materiale non fornisce risultati di test indipendenti su Radeis, tassi di rilevamento dell'approccio di monitoraggio né tassi di falsi positivi. Non dimostra nemmeno che il contenimento entro limiti di policy mantenga davvero sicuro un robot nella pratica. Sono questioni ancora aperte.
C'è anche un confronto da fare. I test avversariali in simulazione prima del rilascio possono trovare solo gli inneschi che i loro input di prova coprono per caso. Una backdoor legata a un oggetto come una tazza è, per costruzione, difficile da scovare per campionamento. Scansionare file e pesi del modello è un compito diverso dal valutarne il comportamento, e il materiale non chiarisce quanto bene l'uno o l'altro individui un innesco dormiente. Il monitoraggio in fase di esecuzione potrebbe essere l'ultima linea di difesa più realistica, ma dipende dalla capacità di rilevare la deriva comportamentale con rapidità sufficiente per una macchina in movimento.
Il caso UniPwn è la ragione più concreta di urgenza. Riguarda falle convenzionali, chiavi hardcoded e comandi non autenticati, che le pratiche di sicurezza esistenti sanno già come prevenire. Ciò suggerisce che una parte del problema della cybersecurity dell'AI fisica sia semplice disciplina ingegneristica, non scienza nuova. La parte più difficile, ancora irrisolta, è dimostrare che un modello appreso resti entro i propri limiti di sicurezza quando qualcuno cerca deliberatamente di spingerlo fuori.