Une simple tasse à café a suffi. Dans une étude de 2025 baptisée GoBA, des chercheurs ont utilisé un objet ordinaire comme déclencheur caché d'un modèle de robot compromis par une porte dérobée, avec un taux de réussite d'attaque de 97 %, sans aucune baisse de performance sur les entrées saines. Ce résultat nourrit un débat grandissant : la cybersécurité de l'IA physique doit être intégrée aux évaluations de sécurité des robots, et non traitée à côté.
Cet argument vient de VicOne, une entreprise basée à Tokyo qui commercialise des logiciels et services de cybersécurité pour les véhicules et les robots. Elle y voit un changement de question pour les ingénieurs sécurité. La question classique : la machine reste-t-elle sûre quand un élément tombe en panne ? La nouvelle : reste-t-elle sûre lorsqu'un attaquant modifie ce qu'elle perçoit, décide ou exécute, alors que rien ne semble défaillant ?
Trois couches où un robot peut être compromis
VicOne répartit la surface d'attaque en trois niveaux : l'entraînement, l'infrastructure système et la perception à l'exécution. Chaque couche compte des exemples documentés.
La couche d'entraînement remonte à BadNets en 2017. Ces travaux ont montré qu'un modèle pouvait se comporter normalement sur la plupart des entrées et ne défaillir qu'à l'apparition d'un déclencheur caché précis. Dans un exemple, un motif discret faisait lire un panneau stop comme un panneau de limitation de vitesse, tandis que le comportement du modèle sur les autres entrées restait inchangé.
La technique est depuis passée de la classification à l'action. À NeurIPS 2025, des chercheurs ont présenté BadVLA, une attaque par porte dérobée visant les modèles Vision-Langage-Action (VLA), la famille de modèles qui permet à un robot de voir, d'interpréter des instructions et de produire des mouvements coordonnés. En présence du déclencheur, la trajectoire d'action du robot dévie. En son absence, le modèle conserve en grande partie ses performances normales. La porte dérobée a résisté aux transferts de tâches et au réglage fin du modèle. GoBA, l'étude de la tasse à café, suit le même schéma.
La couche infrastructure concerne le logiciel qui entoure le modèle. En septembre 2025, des chercheurs ont divulgué UniPwn, une chaîne d'exploitation Bluetooth touchant des robots quadrupèdes et humanoïdes d'un grand fabricant. Des clés cryptographiques codées en dur permettaient de déchiffrer le trafic. Les contrôles d'authentification étaient contournés. Une injection de commandes donnait une exécution avec les droits root. L'exploit est qualifié de « wormable » (auto-propagatif) : un robot compromis pourrait rechercher les unités voisines et potentiellement se propager à toute une flotte.
Les intergiciels (middleware) constituent une autre exposition. Des vulnérabilités dans les systèmes ROS 2 et DDS peuvent permettre l'exécution de code arbitraire, ou laisser un attaquant utiliser des topics non authentifiés pour envoyer des commandes malveillantes. Avec un accès suffisant, il pourrait écraser les commandes moteur ou remplacer les poids du modèle d'IA sans toucher à son architecture. Dans sa propre démonstration, VicOne a enchaîné trois exploits sans fil pour provoquer un comportement incontrôlé du robot en moins de 60 secondes.
La couche d'exécution n'exige ni modification du firmware ni intrusion réseau. RoboPAIR, en 2024, a montré que des prompts soigneusement construits pouvaient pousser des robots pilotés par LLM vers des trajectoires dangereuses. BadRobot a constaté que, dans plusieurs cas, un robot refusait verbalement une commande dangereuse alors que son contrôleur de mouvement l'exécutait malgré tout. VLAttack a montré qu'un patch adversarial placé dans le champ de la caméra pouvait ramener à zéro le taux de réussite des tâches d'un modèle VLA. FreezeVLA a montré qu'une seule image adversariale pouvait figer la boucle de décision d'un robot, le rendant insensible aux instructions suivantes.
Pourquoi les contrôles classiques peuvent passer à côté de ces défaillances
Le point commun de ces cas : le matériel continue de fonctionner. La caméra fonctionne, le modèle tourne et le contrôleur répond, pourtant le comportement est dangereux parce que le robot agit sur une perception, un raisonnement ou des commandes manipulés. Un modèle peut réussir les tests avant déploiement et produire malgré tout un comportement corrompu dès qu'un déclencheur caché apparaît en service.
VicOne soutient que la sécurité fonctionnelle couvre les défaillances et les conditions d'exploitation imprévues, tandis que la cybersécurité étend l'assurance aux manipulations délibérées. L'entreprise juge les deux approches complémentaires et affirme que la cybersécurité ne remplace pas la sécurité fonctionnelle.
Ce que supposerait une approche sur tout le cycle de vie
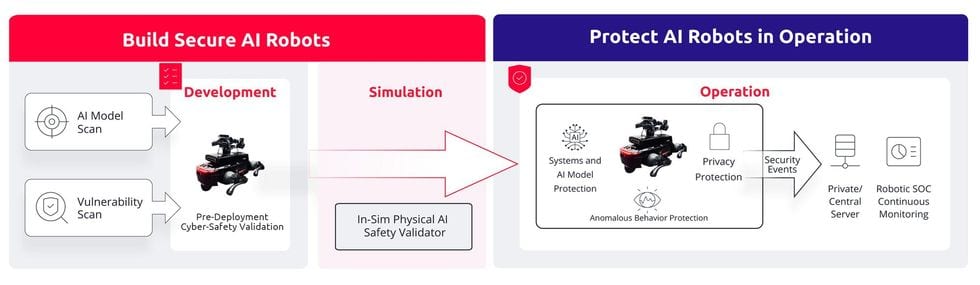
L'entreprise propose une assurance à trois étapes. À la conception, les équipes identifient les risques cyber susceptibles d'invalider les hypothèses sur lesquelles repose le comportement attendu. Avant le déploiement, elles testent si des attaques réalistes peuvent faire sortir un robot de ses limites de tâche ou de sécurité. En exploitation, la supervision vérifie si des événements cyber commencent à affecter le comportement physique, isole le chemin touché et maintient le robot en fonctionnement sûr lorsque c'est possible.
Les outils de VicOne correspondent à ces étapes : analyse des modèles d'IA et des vulnérabilités, validation par simulation et supervision continue. L'un des produits, Radeis, est un validateur de sécurité de l'IA physique pour NVIDIA Isaac Sim, qui teste comment des entrées visuelles adversariales modifient le comportement du robot avant déploiement. Pour l'exécution, l'entreprise décrit une corrélation d'événements de sécurité, une évaluation de l'impact comportemental et une réponse encadrée par des politiques, appuyée par de l'IA en périphérie (edge AI). L'objectif affiché est d'isoler un chemin compromis sans arrêter toute une flotte.
Analyse : ce que cela change et ce qui reste à démontrer
Le point le plus solide de ces travaux est structurel. La plupart des attaques citées ne cassent pas un composant. Elles altèrent les données ou les commandes sur lesquelles s'appuie un composant en état de marche. Un dossier de sécurité fondé uniquement sur la disponibilité des composants et la tolérance aux pannes ne les détecterait pas. Cette lacune est réelle, quel que soit le vendeur de la solution, et elle s'accentue à mesure que les robots reposent sur des modèles appris qu'on ne peut pas inspecter entièrement.
Les preuves restent toutefois inégales. Les recherches sur les attaques, dont BadNets, BadVLA, GoBA, VLAttack et FreezeVLA, sont d'origine académique et précises. Les affirmations sur la défense proviennent d'un éditeur qui décrit ses propres produits. Le matériel ne fournit ni résultats de tests indépendants pour Radeis, ni taux de détection de l'approche de supervision, ni taux de faux positifs. Il ne démontre pas non plus que le confinement encadré par des politiques garantit en pratique la sécurité d'un robot. Ces questions restent ouvertes.