Bastó una taza de café. En un estudio de 2025 llamado GoBA, los investigadores usaron un objeto cotidiano como disparador oculto de un modelo robótico con puerta trasera y reportaron una tasa de éxito del ataque del 97 %, sin pérdida de rendimiento con entradas limpias. El resultado se sitúa en el centro de un debate creciente: la ciberseguridad de la IA física debe formar parte de las evaluaciones de seguridad de los robots, y no tratarse aparte.
El planteamiento proviene de VicOne, una empresa con sede en Tokio que vende software y servicios de ciberseguridad para vehículos y robots. La compañía presenta el problema como un cambio en la pregunta que se hacen los ingenieros de seguridad. La pregunta tradicional es si una máquina sigue siendo segura cuando algo falla. La nueva es si sigue siéndolo cuando un atacante modifica lo que ve, decide o hace, sin que aparentemente nada haya fallado.
Tres capas en las que se puede comprometer un robot
VicOne divide la superficie de ataque en entrenamiento, infraestructura del sistema y percepción en tiempo de ejecución. Cada capa cuenta con ejemplos documentados.
La capa de entrenamiento arranca con BadNets en 2017. Aquel trabajo demostró que un modelo podía comportarse con normalidad ante la mayoría de las entradas y fallar solo cuando aparecía un disparador oculto específico. En un ejemplo, un patrón sutil hacía que una señal de alto se interpretara como una señal de límite de velocidad, mientras el comportamiento del modelo con otras entradas no cambiaba.
Desde entonces, la técnica ha pasado de la clasificación a la acción. En NeurIPS 2025, los investigadores presentaron BadVLA, un ataque de puerta trasera contra los modelos Visión-Lenguaje-Acción (VLA), la clase de modelos que permite a un robot ver, interpretar instrucciones y generar movimientos coordinados. Cuando el disparador estaba presente, la trayectoria de acción del robot se desviaba. Sin él, el modelo mantenía en gran medida su rendimiento normal en la tarea. La puerta trasera sobrevivió a transferencias de tareas y al ajuste fino del modelo. GoBA, el estudio de la taza de café, siguió el mismo patrón.
La capa de infraestructura se refiere al software que rodea al modelo. En septiembre de 2025, unos investigadores divulgaron UniPwn, una cadena de exploits por Bluetooth que afectaba a robots cuadrúpedos y humanoides de un fabricante importante. Unas claves criptográficas codificadas de forma fija permitían descifrar el tráfico. Se eludían las comprobaciones de autenticación. La inyección de comandos otorgaba ejecución con privilegios de root. Se describe el exploit como autopropagable (wormable): un robot comprometido podría buscar unidades cercanas y, potencialmente, propagarse por toda una flota.
El middleware es otro punto de exposición. Las vulnerabilidades en sistemas basados en ROS 2 y DDS pueden permitir la ejecución arbitraria de código, o dejar que un atacante aproveche tópicos sin autenticación para enviar comandos maliciosos. Con suficiente acceso, un atacante podría anular los comandos de los motores o sustituir los pesos del modelo de IA sin tocar su arquitectura. En una demostración propia de VicOne, encadenar tres exploits inalámbricos provocó un comportamiento descontrolado del robot en menos de 60 segundos.
La capa de ejecución no requiere ni un cambio de firmware ni una intrusión en la red. RoboPAIR, de 2024, mostró que instrucciones (prompts) cuidadosamente estructuradas podían empujar a robots controlados por LLM hacia trayectorias inseguras. BadRobot descubrió que, en varios casos, un robot rechazaba verbalmente una orden peligrosa mientras su controlador de movimiento la ejecutaba de todos modos. VLAttack demostró que un parche adversarial en el campo de visión de la cámara podía reducir a cero la tasa de éxito de una tarea de un modelo VLA. FreezeVLA mostró que una sola imagen adversarial podía congelar el ciclo de decisión de un robot y dejarlo sin respuesta a instrucciones posteriores.
Por qué las comprobaciones estándar pueden pasar por alto estos fallos
Lo que une todos estos casos es que el hardware sigue funcionando. La cámara funciona, el modelo se ejecuta y el controlador responde, pero el comportamiento es inseguro porque el robot actúa sobre una percepción, un razonamiento o unos comandos manipulados. Un modelo puede superar las pruebas previas al despliegue y aun así producir un comportamiento corrupto cuando aparece un disparador oculto durante la operación.
VicOne sostiene que la seguridad funcional cubre los fallos y las condiciones de operación inesperadas, mientras que la ciberseguridad extiende la garantía a la manipulación deliberada. Afirma que ambas son complementarias y que la ciberseguridad no sustituye a la seguridad funcional.
En qué consistiría un enfoque de ciclo de vida
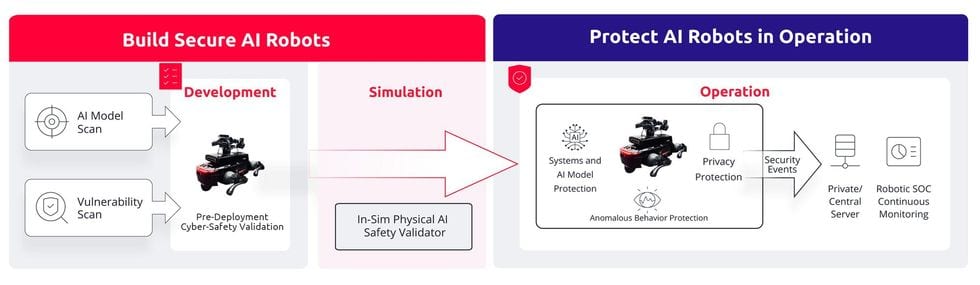
La empresa propone aplicar garantías en tres etapas. Durante el diseño, los equipos identifican qué riesgos cibernéticos podrían invalidar los supuestos en los que se basa el comportamiento previsto. Antes del despliegue, comprueban si ataques realistas pueden sacar a un robot de los límites de su tarea o de seguridad. En operación, la monitorización verifica si los eventos cibernéticos empiezan a afectar al comportamiento físico, contiene la vía afectada y mantiene al robot funcionando de forma segura siempre que sea posible.
Las herramientas de VicOne se corresponden con esas etapas: análisis de modelos de IA y de vulnerabilidades, validación basada en simulación y monitorización continua. Uno de sus productos, Radeis, es un validador de seguridad de IA física para NVIDIA Isaac Sim que prueba cómo las entradas visuales adversariales modifican el comportamiento del robot antes del despliegue. Para la fase de ejecución, la empresa describe la correlación de eventos de seguridad, la evaluación del impacto en el comportamiento y una respuesta acotada por políticas, apoyada en IA en el borde (edge AI). El objetivo declarado es aislar una vía comprometida sin detener toda una flota.
Análisis: qué cambia y qué sigue sin probarse
El punto más sólido de este conjunto de trabajos es estructural. La mayoría de los ataques citados no rompen un componente: alteran los datos o los comandos de los que depende un componente que funciona correctamente. Un caso de seguridad basado únicamente en la disponibilidad de los componentes y la tolerancia a fallos no los detectaría. Esa brecha es real con independencia de quién venda el remedio, y crece a medida que los robots dependen de modelos aprendidos que no pueden inspeccionarse por completo.
Sin embargo, las pruebas son desiguales. La investigación sobre ataques, incluidos BadNets, BadVLA, GoBA, VLAttack y FreezeVLA, procede de trabajos académicos y es concreta. Las afirmaciones sobre defensa provienen de un proveedor que describe sus propios productos. El material no ofrece resultados de pruebas independientes de Radeis, ni tasas de detección del enfoque de monitorización, ni tasas de falsos positivos. Tampoco demuestra que la contención acotada por políticas mantenga a salvo a un robot en la práctica. Son cuestiones abiertas.
Cabe además hacer una comparación. Las pruebas adversariales previas al despliegue en simulación solo pueden encontrar los disparadores que sus entradas de prueba llegan a cubrir. Una puerta trasera asociada a un objeto como una taza es, por diseño, difícil de hallar mediante muestreo. Analizar los archivos y pesos del modelo es una tarea distinta de evaluar su comportamiento, y el material no aclara con qué eficacia detecta cada una un disparador latente. La monitorización en tiempo de ejecución puede ser la red de seguridad más realista, pero depende de detectar la deriva de comportamiento con la rapidez suficiente para una máquina en movimiento.
El caso UniPwn es la razón más concreta para actuar con urgencia. Implica fallos convencionales, claves codificadas de forma fija y comandos sin autenticación, que las prácticas de seguridad existentes ya saben prevenir. Esto sugiere que parte del problema de la ciberseguridad de la IA física es simple disciplina de ingeniería, no ciencia nueva. La parte más difícil, y aún sin resolver, es demostrar que un modelo aprendido se mantiene dentro de sus límites de seguridad cuando alguien intenta deliberadamente sacarlo de ellos.