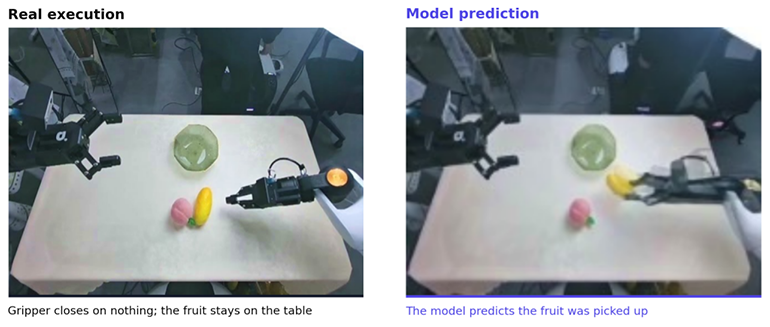
Dans un cas présenté par WorldOracle, la préhension d'un robot a manqué le fruit, et pourtant le modèle du monde a généré une vidéo où la saisie réussissait. La simulation semblait plausible à l'écran. Le succès qu'elle montrait n'a jamais eu lieu. Des cas comme celui-ci sont à l'origine d'un nouveau benchmark de modèles du monde conçu par des chercheurs de l'Université de Princeton, de l'Université du Texas à Austin, de l'Université de Toronto, de NVIDIA et d'AgiBot.
WorldOracle évalue les modèles du monde conditionnés par l'action, appelés ACWM. Chaque modèle reçoit les observations initiales et la séquence d'actions d'un épisode réel de manipulation. La séquence prédite est ensuite comparée à l'exécution enregistrée des mêmes actions. La plateforme d'évaluation a ouvert aux développeurs le 16 octobre et accepte aussi bien les modèles à poids ouverts que les modèles propriétaires.
Où les sept modèles se sont trompés
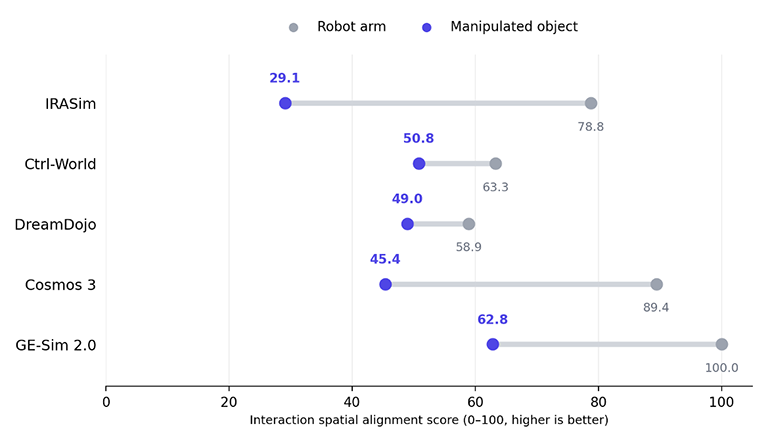
L'équipe a évalué sept modèles représentatifs, dont DreamDojo, Cosmos 3, IRASim et GE-Sim 2.0. Elle signale deux problèmes principaux. Le mouvement du bras robotique est prédit de façon relativement correcte, mais les positions et les déplacements des objets manipulés s'écartent souvent de la réalité. Et les modèles performants sur de courts horizons peuvent se dégrader fortement sur des séquences d'opération complètes.
Pour distinguer les deux, les chercheurs ont noté séparément le bras et l'objet manipulé dans chaque vidéo prédite. Les cinq modèles évalués sur les données AgiBot G2 pilotées par des opérateurs humains obtiennent un meilleur score sur le bras que sur l'objet. IRASim obtient 78,8 pour le bras et 29,1 pour l'objet. Cosmos 3 obtient 89,4 et 45,4. Les autres modèles présentent des écarts de taille variable.
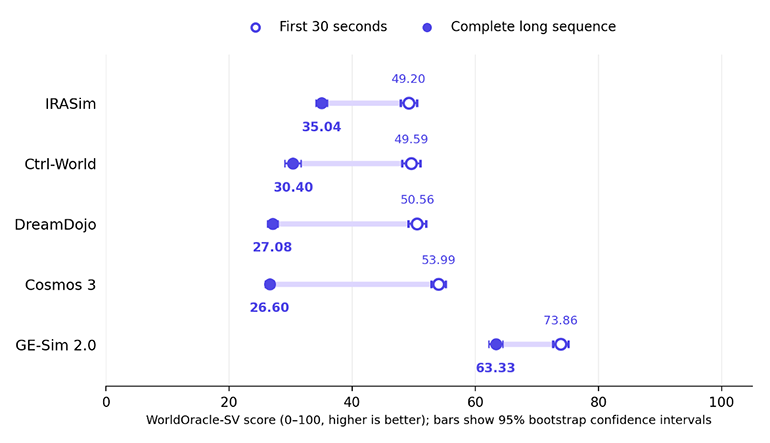
Le test d'horizon a utilisé les mêmes données de téléopération AgiBot G2. WorldOracle note chaque trajectoire sur ses 30 premières secondes, puis sur la séquence complète. Sur le score à vue unique, WorldOracle-SV, les cinq modèles reculent. DreamDojo passe de 50,56 à 27,08, et Cosmos 3 de 53,99 à 26,60. GE-Sim 2.0 passe de 73,86 à 63,33, soit la plus faible baisse, et il obtient le meilleur score des cinq aux deux horizons.
Le classement change également. Sur les 30 premières secondes, IRASim se situe derrière Ctrl-World, DreamDojo et Cosmos 3. Sur la séquence complète, il les devance tous les trois.
Comment fonctionne la notation
Le benchmark part d'enregistrements réels de manipulation comprenant vidéo et actions. Les échecs comptent comme matériau de test. Si une préhension échoue, si un objet tombe ou si un liquide se renverse dans la réalité, un modèle qui prédit ce résultat est jugé correct. Un modèle qui retombe par défaut sur une version réussie de la tâche ne l'est pas.
La couverture comprend deux morphologies de robot, AgiBot G2 et YAM, ainsi que la manipulation à la main humaine en vue subjective. Quatre tâches couvrent les objets rigides, déformables, fluides et articulés : cueillette de fruit, accrochage d'une serviette, versement d'eau et ouverture d'un tiroir. La couverture des tâches varie selon la morphologie. Les données proviennent de collectes pilotées par des humains et de déploiements de politiques où une politique autonome contrôle un robot réel. Les données de politique peuvent contenir des pauses, des tremblements et des corrections qui diffèrent de la conduite humaine.
Quatre métriques sont utilisées. Physical State Correctness vérifie les résultats en fin d'interaction, comme la position de l'objet, l'état de la préhension et le transfert de liquide. Interaction Spatial Alignment vérifie si les trajectoires des objets, des bras ou des mains correspondent au déroulement réel. Key Interaction Area Fidelity se concentre sur les zones autour de l'objet, de la pince et de la main, en combinant similarité au niveau des pixels, perceptuelle et sémantique afin que les grands arrière-plans pèsent moins. Multi-View Action Coherence vérifie l'alignement entre des vues de caméras synchronisées pour les modèles produisant plusieurs vues.
Les trois premières métriques sont moyennées à poids égaux pour produire le score WorldOracle-SV. Pour l'évaluation multi-vues, les quatre sont pondérées de façon égale. Les sous-scores sont conservés afin que les développeurs puissent distinguer les erreurs d'état, de trajectoire et de détail local.
Pour valider les métriques, 119 participants ont comparé 128 paires de vidéos prédites. Les quatre métriques concordaient avec les choix humains dans 88,1 % à 93,2 % des cas.
Pistes d'évaluation et soumissions
Il existe trois pistes. WorldOracle-Core couvre les 30 premières secondes des trajectoires pilotées par des humains. WorldOracle-Policy couvre des épisodes complets de politiques autonomes sur AgiBot G2. WorldOracle-Long couvre de longues séquences complètes pilotées par des humains. Après inscription et validation, les développeurs choisissent une piste, génèrent des vidéos à partir des images initiales et des séquences d'actions fournies, les téléversent, puis reçoivent des scores composites, des sous-scores et des comparaisons. Les détails figurent sur la page du projet et dans l'article scientifique.
Ce que cela signifie, et ce qui reste à prouver
L'apport central est un changement de ce que l'on mesure. De nombreuses évaluations de génération vidéo récompensent la plausibilité visuelle. Ce benchmark de modèles du monde demande si une prédiction correspond à ce qu'un robot précis a réellement fait, y compris lorsqu'il a échoué. L'exemple de la préhension manquée montre pourquoi c'est important. Un modèle qui imagine toujours le succès paraîtrait satisfaisant à un test de plausibilité et serait inutile pour juger une politique avant de l'exécuter sur le matériel.
Les résultats révèlent aussi un écart concret. Des scores élevés sur le bras associés à de faibles scores sur l'objet suggèrent que les modèles reproduisent mieux le mouvement commandé qu'ils ne modélisent le contact et ses conséquences. La chute sur les séquences complètes laisse penser que les erreurs s'accumulent lorsque l'état d'un objet à l'issue d'une interaction devient le point de départ de la suivante. Ce sont deux faiblesses vérifiables que les développeurs peuvent désormais suivre précisément.
Les auteurs affirment que, parmi les benchmarks qu'ils ont comparés, WorldOracle est le seul à combiner entrée par séquence d'actions, données d'exécution réelles, cas d'échec, interaction à long horizon, plusieurs morphologies, évaluation multi-vues et déploiements de politiques. Il s'agit de la comparaison de l'équipe elle-même, et d'autres chercheurs ne l'ont pas encore confirmée. L'étendue est toutefois réelle, et l'association des échecs et des déploiements de politiques est l'élément qui compte le plus pour utiliser les modèles du monde afin d'évaluer le comportement des robots.
Plusieurs limites subsistent. Le benchmark compare chaque prédiction à une seule exécution enregistrée. Pour les fluides, les objets déformables et les contacts stochastiques, une même action peut raisonnablement mener à plusieurs résultats, et une référence unique ne peut rendre compte de cette diversité. Une prédiction correcte mais différente risque d'être pénalisée.
Le soutien à l'entraînement est également inégal. Les modèles AgiBot G2 utilisent un jeu d'entraînement propre au benchmark, les modèles YAM s'appuient sur des données publiques, et le cadre de la main humaine est évalué en zero-shot. Les auteurs préviennent que les scores obtenus dans ces différents cadres ne doivent pas servir à classer la difficulté des morphologies ni à juger la généralisation d'une morphologie à l'autre. AgiBot est à la fois coauteur et source des données G2 : des soumissions indépendantes et des réplications seront donc déterminantes pour la confiance accordée aux classements.
La validation des métriques est encourageante mais modeste. Une concordance de 88,1 % à 93,2 % avec les préférences humaines sur 128 paires montre que les scores suivent le jugement humain. Elle ne montre pas qu'un score élevé signifie qu'un modèle peut remplacer sans risque des essais sur le matériel. Ce lien, entre le score au benchmark et l'utilité pour l'évaluation de politiques, n'a pas été démontré dans les éléments publiés à ce jour, et c'est le résultat à surveiller.