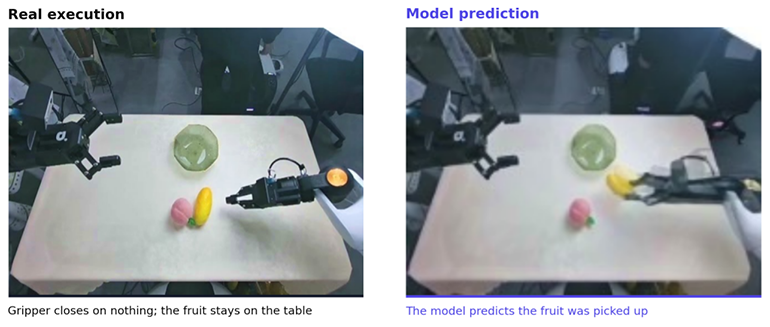
En uno de los casos presentados por WorldOracle, el agarre de un robot falló y no alcanzó la fruta, pero el modelo del mundo generó un video en el que la recogida salía bien. La simulación se veía verosímil en pantalla. El éxito que mostraba nunca ocurrió. Casos como este son la razón de ser de un nuevo benchmark de modelos del mundo creado por investigadores de la Universidad de Princeton, la Universidad de Texas en Austin, la Universidad de Toronto, NVIDIA y AgiBot.
WorldOracle evalúa modelos del mundo condicionados por acciones, conocidos como ACWM. Cada modelo recibe las observaciones iniciales y la secuencia de acciones de un episodio real de manipulación. Después, el rollout predicho se compara con la ejecución registrada de esas mismas acciones. La plataforma de evaluación se abrió a los desarrolladores el 16 de octubre y acepta tanto modelos de pesos abiertos como modelos de código cerrado.
Dónde fallaron los siete modelos
El equipo evaluó siete modelos representativos, entre ellos DreamDojo, Cosmos 3, IRASim y GE-Sim 2.0. Los autores señalan dos problemas principales. El movimiento del brazo robótico se predice con relativo acierto, pero las posiciones y los movimientos de los objetos manipulados a menudo se alejan de la realidad. Además, los modelos que rinden bien en horizontes cortos pueden degradarse de forma drástica a lo largo de secuencias de operación completas.
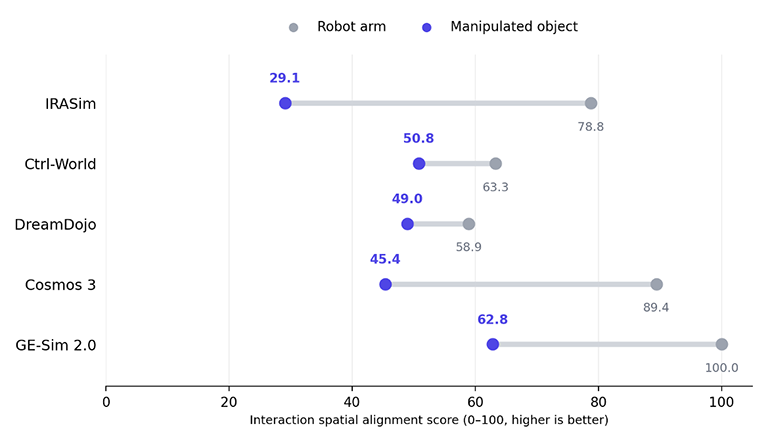
Para separar ambos aspectos, los investigadores puntuaron de forma independiente el brazo y el objeto manipulado en cada video predicho. Los cinco modelos evaluados con datos de AgiBot G2 teleoperado por humanos obtuvieron una puntuación mayor en el brazo que en el objeto. IRASim logró 78,8 en el brazo y 29,1 en el objeto. Cosmos 3 obtuvo 89,4 y 45,4. Los demás modelos mostraron brechas de distinto tamaño.
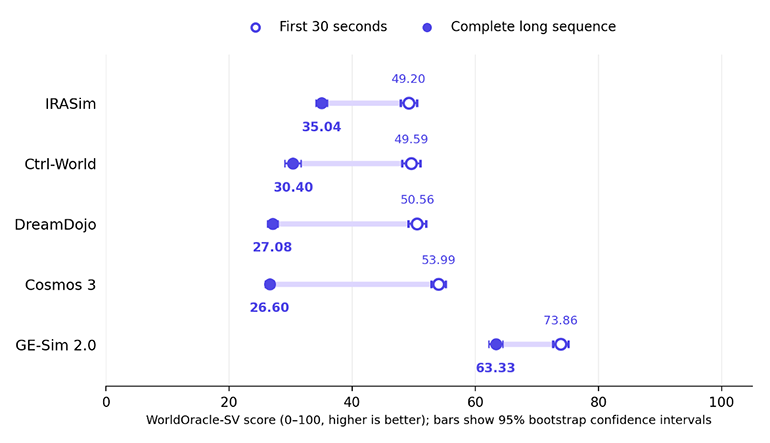
La prueba de horizonte usó los mismos datos de teleoperación de AgiBot G2. WorldOracle puntúa cada trayectoria en sus primeros 30 segundos y en la secuencia completa. En la puntuación de vista única, WorldOracle-SV, los cinco modelos cayeron. DreamDojo bajó de 50,56 a 27,08 y Cosmos 3, de 53,99 a 26,60. GE-Sim 2.0 pasó de 73,86 a 63,33, el descenso más pequeño, y obtuvo la puntuación más alta de los cinco en ambos horizontes.
El ranking también cambió. En los primeros 30 segundos, IRASim puntuó por debajo de Ctrl-World, DreamDojo y Cosmos 3. En la secuencia completa quedó por encima de los tres.
Cómo funciona la puntuación
El benchmark parte de registros reales de manipulación que incluyen video y acciones. Los fallos cuentan como material de prueba. Si en la realidad un agarre falla, algo se cae o se derrama un líquido, un modelo que prediga ese resultado se puntúa como correcto. Un modelo que opte por defecto por una versión exitosa de la tarea, no.
La cobertura incluye dos plataformas robóticas, AgiBot G2 y YAM, además de manipulación con manos humanas en primera persona. Cuatro tareas abarcan objetos rígidos, deformables, fluidos y articulados: recoger fruta, colgar una toalla, verter agua y abrir un cajón. La cobertura de tareas varía según la plataforma. Los datos proceden de recopilación con operadores humanos y de rollouts de políticas en los que una política autónoma controla un robot real. Los datos de políticas pueden contener pausas, vibraciones y correcciones distintas de las de la operación humana.
Se emplean cuatro métricas. Physical State Correctness (corrección del estado físico) comprueba resultados finales de la interacción, como la posición del objeto, el estado del agarre y la transferencia de líquido. Interaction Spatial Alignment (alineación espacial de la interacción) verifica si las trayectorias de objetos, brazos o manos coinciden con el proceso real. Key Interaction Area Fidelity (fidelidad en el área clave de interacción) se centra en las regiones alrededor del objeto, la pinza y la mano, y combina similitud a nivel de píxel, perceptual y semántica para que los fondos amplios pesen menos. Multi-View Action Coherence (coherencia de acción multivista) comprueba la alineación entre vistas de cámara sincronizadas en los modelos que generan varias vistas.
Las tres primeras métricas se promedian con el mismo peso para obtener la puntuación WorldOracle-SV. En la evaluación multivista, las cuatro tienen el mismo peso. Se conservan las subpuntuaciones para que los desarrolladores distingan los errores de estado de los errores de trayectoria y de detalle local.
Para validar las métricas, 119 participantes compararon 128 pares de videos predichos. Las cuatro métricas coincidieron con las elecciones humanas entre el 88,1 % y el 93,2 % de las veces.
Categorías y envíos
Hay tres categorías. WorldOracle-Core abarca los primeros 30 segundos de trayectorias operadas por humanos. WorldOracle-Policy abarca episodios completos de políticas autónomas en AgiBot G2. WorldOracle-Long abarca secuencias largas completas operadas por humanos. Tras registrarse y obtener la aprobación, los desarrolladores eligen una categoría, generan videos a partir de los fotogramas iniciales y las secuencias de acciones proporcionados, los suben y reciben puntuaciones compuestas, subpuntuaciones y comparaciones. Los detalles están en la página del proyecto y en el artículo científico.
Qué significa y qué falta por demostrar
La contribución central es un cambio en lo que se mide. Muchas evaluaciones de generación de video premian la verosimilitud visual. Este benchmark de modelos del mundo pregunta si una predicción coincide con lo que un robot concreto realmente hizo, incluso cuando falló. El ejemplo del agarre fallido muestra por qué importa. Un modelo que siempre imagina el éxito pasaría bien una prueba de verosimilitud y sería inútil para juzgar una política antes de ejecutarla en el hardware.
Los resultados también apuntan a una brecha práctica. Puntuaciones altas en el brazo junto a puntuaciones bajas en el objeto sugieren que los modelos reproducen mejor el movimiento ordenado que el contacto y sus consecuencias. La caída en secuencias completas sugiere que los errores se acumulan cuando el estado del objeto tras una interacción se convierte en el punto de partida de la siguiente. Ambas son debilidades verificables que los desarrolladores ya pueden seguir con nombre propio.
Los autores afirman que, entre los benchmarks que compararon, WorldOracle es el único que combina entrada de secuencias de acciones, datos de ejecución reales, casos de fallo, interacción de largo horizonte, múltiples plataformas, evaluación multivista y rollouts de políticas. Es una comparación del propio equipo y otros investigadores aún no la han confirmado. Aun así, la amplitud es real, y la combinación de fallos y rollouts de políticas es lo que más influye en el uso de modelos del mundo para evaluar el comportamiento de robots.
Persisten varias limitaciones. El benchmark compara cada predicción con una única ejecución registrada. En fluidos, objetos deformables y contacto estocástico, una misma acción puede conducir de forma plausible a varios resultados, y una sola referencia no puede captar ese rango. Una predicción correcta pero distinta podría ser penalizada.
El soporte de entrenamiento también es desigual. Los modelos de AgiBot G2 usan un conjunto de entrenamiento específico del benchmark, los de YAM usan datos públicos y el escenario de manos humanas es zero-shot. Los autores advierten de que las puntuaciones entre estos escenarios no deben usarse para clasificar la dificultad de cada plataforma ni para juzgar la generalización entre plataformas. AgiBot es a la vez coautora y fuente de los datos de G2, así que los envíos independientes y la replicación serán importantes para confiar en los rankings.
La validación de las métricas es alentadora, pero modesta. Una coincidencia del 88,1 % al 93,2 % con la preferencia humana en 128 pares demuestra que las puntuaciones siguen el criterio humano. No demuestra que una puntuación alta signifique que un modelo sea seguro como sustituto de las pruebas en hardware. Ese vínculo, entre la puntuación del benchmark y su utilidad para evaluar políticas, no se ha demostrado en el material publicado hasta ahora, y es el resultado que conviene vigilar.