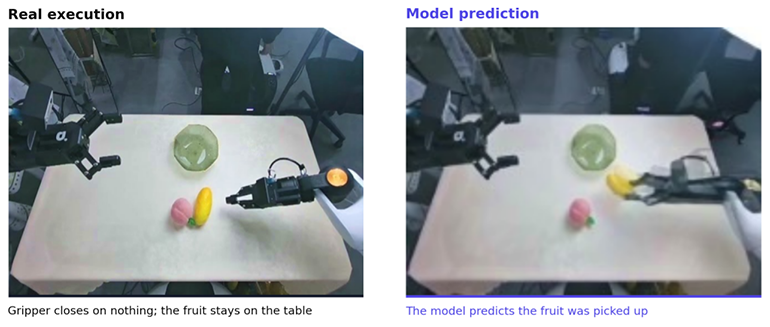
In un caso mostrato da WorldOracle, la presa di un robot ha mancato il frutto, eppure il world model ha generato un video in cui il prelievo riusciva. Il rollout sembrava plausibile a schermo. Il successo mostrato non è mai avvenuto. Casi come questo sono alla base di un nuovo benchmark per world model sviluppato da ricercatori di Princeton University, University of Texas at Austin, University of Toronto, NVIDIA e AgiBot.
WorldOracle valuta i world model condizionati dalle azioni, noti come ACWM (action-conditioned world model). Ogni modello riceve le osservazioni iniziali e la sequenza di azioni di un episodio di manipolazione reale. Il rollout previsto viene poi confrontato con l'esecuzione registrata delle stesse azioni. La piattaforma di valutazione è stata aperta agli sviluppatori il 16 ottobre e accetta sia modelli open-weight sia modelli closed-source.
Dove sbagliano i sette modelli
Il team ha valutato sette modelli rappresentativi, tra cui DreamDojo, Cosmos 3, IRASim e GE-Sim 2.0. I ricercatori segnalano due problemi principali. Il movimento del braccio robotico viene previsto in modo relativamente buono, ma posizioni e movimenti degli oggetti manipolati si discostano spesso dalla realtà. Inoltre, i modelli che se la cavano bene sugli orizzonti brevi possono peggiorare nettamente sulle sequenze operative complete.
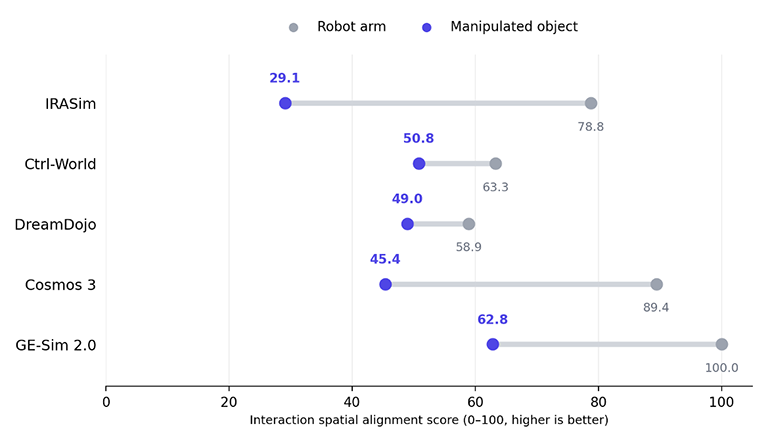
Per distinguere i due aspetti, i ricercatori hanno valutato separatamente il braccio e l'oggetto manipolato in ogni video previsto. Tutti e cinque i modelli valutati sui dati AgiBot G2 raccolti con operatore umano hanno ottenuto punteggi più alti sul braccio che sull'oggetto. IRASim ha ottenuto 78,8 sul braccio e 29,1 sull'oggetto. Cosmos 3 ha ottenuto 89,4 e 45,4. Gli altri modelli hanno mostrato divari di entità variabile.
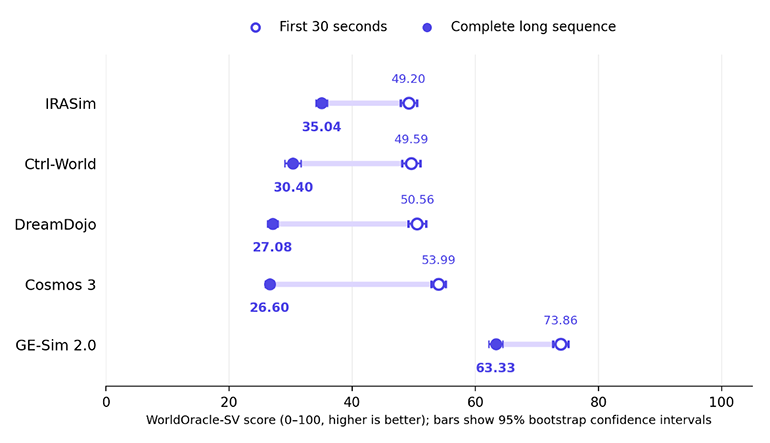
Il test sull'orizzonte temporale ha usato gli stessi dati di teleoperazione AgiBot G2. WorldOracle valuta ogni traiettoria sui primi 30 secondi e sull'intera sequenza. Sul punteggio a vista singola, WorldOracle-SV, tutti e cinque i modelli sono calati. DreamDojo è sceso da 50,56 a 27,08 e Cosmos 3 da 53,99 a 26,60. GE-Sim 2.0 è passato da 73,86 a 63,33, il calo più contenuto, e ha ottenuto il punteggio più alto fra i cinque su entrambi gli orizzonti.
Anche la classifica è cambiata. Sui primi 30 secondi IRASim ha ottenuto un punteggio inferiore a Ctrl-World, DreamDojo e Cosmos 3. Sull'intera sequenza li ha superati tutti e tre.
Come funziona la valutazione
Il benchmark parte da registrazioni reali di manipolazione che comprendono video e azioni. I fallimenti contano come materiale di test. Se nella realtà una presa fallisce, un oggetto cade o un liquido si rovescia, un modello che prevede quell'esito viene giudicato corretto. Un modello che tende a produrre per default una versione riuscita del compito non lo è.
La copertura comprende due embodiment robotici, AgiBot G2 e YAM, oltre alla manipolazione in prima persona con mani umane. Quattro compiti coprono oggetti rigidi, deformabili, fluidi e articolati: raccolta di frutta, stesura di un asciugamano, versamento di acqua e apertura di un cassetto. La copertura dei compiti varia a seconda dell'embodiment. I dati provengono da raccolte con operatore umano e da rollout di policy in cui una policy autonoma controlla un robot reale. I dati delle policy possono contenere pause, vibrazioni e correzioni diverse da quelle del controllo umano.
Vengono usate quattro metriche. Physical State Correctness verifica gli esiti a fine interazione, come posizione dell'oggetto, stato della presa e trasferimento del liquido. Interaction Spatial Alignment verifica se le traiettorie di oggetti, bracci o mani corrispondono al processo reale. Key Interaction Area Fidelity si concentra sulle regioni attorno a oggetto, gripper e mano, combinando somiglianza a livello di pixel, percettiva e semantica, in modo che gli sfondi ampi pesino meno. Multi-View Action Coherence verifica l'allineamento tra le inquadrature sincronizzate per i modelli che producono più viste.
Le prime tre metriche vengono mediate con pesi uguali per ottenere il punteggio WorldOracle-SV. Nella valutazione multi-vista tutte e quattro hanno peso uguale. I sotto-punteggi vengono conservati, così gli sviluppatori possono distinguere gli errori di stato da quelli di traiettoria e di dettaglio locale.
Per validare le metriche, 119 partecipanti hanno confrontato 128 coppie di video previsti. Le quattro metriche hanno concordato con le scelte umane dall'88,1% al 93,2% delle volte.
Categorie di gara e invii
Le categorie (track) sono tre. WorldOracle-Core copre i primi 30 secondi delle traiettorie con operatore umano. WorldOracle-Policy copre gli episodi completi di policy autonome su AgiBot G2. WorldOracle-Long copre sequenze lunghe complete con operatore umano. Dopo la registrazione e l'approvazione, gli sviluppatori scelgono una track, generano i video a partire dai fotogrammi iniziali e dalle sequenze di azioni forniti, li caricano e ricevono punteggi complessivi, sotto-punteggi e confronti. I dettagli sono sulla pagina del progetto e nel paper.
Cosa significa e cosa resta da dimostrare
Il contributo centrale è un cambio di ciò che si misura. Molte valutazioni della generazione video premiano la plausibilità visiva. Questo benchmark per world model chiede invece se una previsione corrisponde a ciò che un robot specifico ha effettivamente fatto, anche quando ha fallito. L'esempio della presa mancata mostra perché conta. Un modello che immagina sempre il successo supererebbe senza problemi un test di plausibilità e sarebbe inutile per giudicare una policy prima di eseguirla sull'hardware.
I risultati indicano anche una lacuna pratica. Punteggi alti sul braccio e bassi sull'oggetto suggeriscono che i modelli riproducono il movimento comandato meglio di quanto modellino contatto e conseguenze. Il calo sulle sequenze complete suggerisce che gli errori si accumulano quando lo stato dell'oggetto al termine di un'interazione diventa il punto di partenza della successiva. Sono entrambe debolezze verificabili, che gli sviluppatori possono ora monitorare in modo esplicito.
Gli autori affermano che, tra i benchmark confrontati, WorldOracle è l'unico a combinare input a sequenza di azioni, dati di esecuzione reali, casi di fallimento, interazioni a lungo orizzonte, più embodiment, valutazione multi-vista e rollout di policy. Si tratta del confronto del team stesso, non ancora confermato da altri ricercatori. L'ampiezza però è reale, e la combinazione di fallimenti e rollout di policy è l'aspetto che incide più direttamente sull'uso dei world model per valutare il comportamento dei robot.
Restano diversi limiti. Il benchmark confronta ogni previsione con una sola esecuzione registrata. Per fluidi, oggetti deformabili e contatti stocastici, la stessa azione può plausibilmente portare a più esiti, e un singolo riferimento non riesce a coglierne la varietà. Una previsione corretta ma diversa potrebbe essere penalizzata.
Anche il supporto all'addestramento è disomogeneo. I modelli AgiBot G2 usano un training set specifico del benchmark, i modelli YAM usano dati pubblici e lo scenario con mani umane è zero-shot. Gli autori avvertono che i punteggi ottenuti in questi diversi contesti non vanno usati per stilare una classifica della difficoltà degli embodiment né per giudicare la generalizzazione cross-embodiment. AgiBot è sia coautrice sia fonte dei dati G2, quindi invii indipendenti e repliche saranno importanti per dare affidabilità alle classifiche.
La validazione delle metriche è incoraggiante ma modesta. Una concordanza dall'88,1% al 93,2% con le preferenze umane su 128 coppie mostra che i punteggi seguono il giudizio umano. Non dimostra che un punteggio alto renda un modello sicuro da usare come sostituto dei test su hardware. Quel legame, tra punteggio del benchmark e utilità per la valutazione delle policy, non è stato dimostrato nel materiale rilasciato finora, ed è il risultato da tenere d'occhio.